
.
片羽
-
Unknown Author
-
Unknown Date
-
About
. 片羽
- Unknown Author
- Unknown Date
- About
此间
[index]
- XXXX-09-26
- Glomzzz
渴望啃噬我们,如海啃噬陆地.
- XXXX-09-26
- Glomzzz
切换到Typsite
[new-ssg]
- 2025-06-08 11:45
- Glomzzz
- 2025-06-08 11:45
- Glomzzz
去年4月, 我基于 Vitepress 开发了 Librorum, 作为能享受整个NPM 生态且支持 Vue3 的 SSG, 其功能是非常丰富的:
- 文章归档(Timeline)
- 分类, 标签, 词云, 全局搜索
- 个性化阅读配置(感谢 Ayaka 与 Neko)
- 支持 (markdown-it-mathjax3)
- And more…
但当你在阅读我那充斥着 鬼画符 的Lambda Calculus页面与拉康精神分析文章, 并认为效果海星时, 在其背后却是这样的:
\begin{align*}
Y_v(M)(1)
&= D(1) \\
&= M\ (\lambda a.\, D(a))\ (1) \\
&= (\lambda f.\, \lambda n.\, \text{if } n = 0 \text{ then } 1 \text{ else } n \cdot f(n - 1))\ (\lambda a.\, D(a))\ (1) \\
&\Rightarrow 1 \cdot (\lambda a.\, D(a))(0) \\
&= 1 \cdot D(0) \\
&= 1 \cdot M\ (\lambda a.\, D(a))\ (0) \\
&= (\lambda f.\, \lambda n.\, \text{if } n = 0 \text{ then } 1 \text{ else } n \cdot f(n - 1))\ (\lambda a.\, D(a))\ (0) \\
&\Rightarrow 1 \cdot 1 \\
&= 1
\end{align*}\begin{align*}
Y_v(M)(1)
&= D(1) \\
&= M\ (\lambda a.\, D(a))\ (1) \\
&= (\lambda f.\, \lambda n.\, \text{if } n = 0 \text{ then } 1 \text{ else } n \cdot f(n - 1))\ (\lambda a.\, D(a))\ (1) \\
&\Rightarrow 1 \cdot (\lambda a.\, D(a))(0) \\
&= 1 \cdot D(0) \\
&= 1 \cdot M\ (\lambda a.\, D(a))\ (0) \\
&= (\lambda f.\, \lambda n.\, \text{if } n = 0 \text{ then } 1 \text{ else } n \cdot f(n - 1))\ (\lambda a.\, D(a))\ (0) \\
&\Rightarrow 1 \cdot 1 \\
&= 1
\end{align*}不得不说, 我的编写体验十分糟糕, 以及当我想画一点拉康鬼画符时, 我的编写体验与作为正文的Markdown是非常割裂的…
当然这也不是我脱更 [Partial Evaluation的坑光挖不填; 拉康精神分析只讲了最不重要的那部分…]的借口 [ 哈哈, 我跑去读德古了]
众所周知, Typst 既有 Markdown 的简洁, 也有 的力量(still growing), 但对我最重要的是: Typst 提供了一种一致性, 它是贯彻整个文章的书写体验的: 所见的一切都可交流.
换句话说,
它提供的是这么一种场域, 在其中无论是作为富文本的文字还是作为非文字的画图/公式, 都在 Content 之中保持着一致性, 例如, 我可以随地声明一段我将来会多次用到的片段, 并在之后甚至其他文章里随意调用.
- 在 Markdown + 的组合中, 世界是线性的, 但会被一段段本应被细分的公式&画图部分所分裂, 在这些裂口中, 世界被割裂成了几个无法互相交流的部分;
- 而在 Typst 之中, 世界是树状(even 图状)的, 并且那些理应被更加细分的内容是确实被细分了的(公式&画图), 并且这些内容与其他内容仿佛本来就是一体的, 他们之间没有隔阂: 它们本就都在同一个世界中
如果只用 呢?
如果你说的是它那关于书写体验上的一致性, 那 what can i say?
允许你改写几乎任何层级的规则和格式, 你拥有堪称强迫症一般的排版上的绝对主权, 而代价却是复杂的语法与漫长的编译
- 当然还有不是那么美好的错误处理系统, 我在 typsite 错误处理与恢复上也是有花了一番功夫…
总之, 贯彻着如此的宗旨: “你可以做任何事情,但你必须知道你在做什么.”
而 Typst 则试图在自由度 & 一致性 & 可用性 之间找到平衡点, 不能不说的是, 它确确实实地做出了很多策略性取舍, 但于此同时它获得的是 可维护性 & 稳定性, 以及高效的写作体验.
这就得吹一波我们 Typst 的实时预览了, 常规文章亚秒级预览就问你舒不舒服; 当然为了实现这一点, typsite也是从设计之初就走上了增量编译之路.
typsite c --port 8000
typsite c --port 8000
开启 watch mode, 并随着你对无论是文章还是配置的任何改动, typsite都会实时的同步并尽力做出最小量的编译.对于我来说, Typst 所尝试寻找的这一平衡点足够平衡, 确实好用!
当然在读到这里时, 稍微混一点PL圈子的读者应该都能察觉到我这里提 与 Typst 是在影射些什么了…
在文章的最后我想引用一段来自 lyzh : 作为意识形态的编程语言 的片段:
曾经追求表达力和自由(如Lisp等)失败了.
状态、副作用、协作的复杂性要求我们戴上“规则”的镣铐跳舞:类型系统、限制副作用、规范依赖.
这是一种“自由的反转”:人受限而程序得以合作.
或者我们可以换句话说
自由的反面不是约束,而是混乱
关于Typsite的inline-svg
[typ-svg]
- 2025-06-26 12:45
- Glomzzz
- 2025-06-26 12:45
- Glomzzz
0.1.6
花了 1 天时间,搞定了 typsite 的 link in inline-svg, 虽然最终效果还行,但由于typst-svg 本身对HTML的适配依然有很大的进步空间 [直接把 TAG 和 LINK 跳过了可还行],我的实现手段也非常的草台,总之在这个站点用用得了,我不是很打算将这个功能推送到 typsite 的主分支上.
Typsite 0.1.7 的 SVG-features 迎来史诗级增强,SVG内可以正常使用 footnote & anchor & link 了,并且有自动fit-font功能(尺寸匹配字体).
1 效果预览
可以来看看效果:
效果展示
test footnote ref: 1
test external link goto: Source of typsite
this is where the
<anchor>
<anchor>
is
Typsite二三想
[typsite-thinking]
- 2026-03-31 23:36
- Glomzzz
- 2026-03-31 23:36
- Glomzzz
1 从何处开始?
一款良好的 General Static Site Generator (GSSG),应当是一个 Content Compiler (CC):
- 输入: 内容、模板、配置、资源
- 中间过程: 解析、建模、路由、聚合、渲染
- 输出: 编译为输出目标
我们当然可以顺理成章地对这一层层结构做抽象,就像这样:
- 输入: (typst), (markdown), (html), (txt), etc.
- 中间过程: 统一的, 语义足够丰富的中间表示
- 输出: 可部署的完整静态网站, pdf, etc.
那么,基于 Why Concrete Syntax Doesnt Matte 文章中所提的观点,我们设计GSSG的重中之重应当是先设计一套良好的中间表示(Interprete Representation).
2 良好的中间表示?
我通常习惯于“Define it by what it does”, 首先,我们应当至少有两层IR:
- 文章层 Slug -> Metadata@(Relations, etc.)
- 内容层 Slug -> Content@(Plain Text, Cite, Embed, etc.)
并且为了性能考虑,它们都应当是被Flatten的.
考虑到
Embed
Embed
的存在,在渲染管线(Rendering Pipeline)中,应当单独生成一层记录了完整依赖信息与内容的渲染节点
- 渲染层 Slug -> Pending@(Plain Text, Cite Content(&Metadata.title), Embed Content(&Pending) etc.)
3 本地编译缓存?
为了加快编译,所有IR层都应当被完全缓存,当某个文章内容变动时则单独重新生成此文章的IR,由于在渲染层中我们所保存的依赖状态均为引用,所以其它所有本身内容未变动的文章不再任何重新编译,我们已经在渲染层记录过文章间的依赖关系,于是我们只用通过查询依赖关系重新将受影响的文章重新渲染到HTML便可
4 实时热更新预览!
实时热更新预览可以极大地提高用户体验,只要依赖信息足够,我们完全可以做到非常丝滑的热增量更新!
5 对于 typsite
既然要做typst这样一种给予用户极大操作能力的可编程标记语言的SSG,就需要在一致性 (Consistency) 与 通用性 (Generality) 之间做妥协了
5.1 typst + markdown ?
一款基于 Typst 的 SSG 不支持 Markdown, 并不必然是缺陷; 相反, 这恰恰可能是一种对系统一致性的坚持.
首先, 若系统的核心渲染模型, 语义表达, 排版能力, 宏系统乃至扩展机制都建立在 Typst 之上, 那么继续额外接纳 Markdown, 实际上就是在同一个系统内部并置两套不同的书写逻辑.表面上看, 这像是在“兼容更多用户习惯”; 但在结构上, 它意味着同一篇内容可以有两种语法, 两种抽象层次, 两种能力边界, 两种预期行为.于是问题便立刻出现: 究竟谁才是系统真正的“母语”?
一旦 Markdown 被纳入, 系统便不得不面对一种持续的分裂: 哪些功能是两者共有的, 哪些是 Typst 独有的, 哪些写法在一种语法中合法却在另一种中失效, 哪些组件可以跨语法复用, 哪些宏只能停留在 Typst 世界之内.开发者不得不不断解释“这里为什么 Markdown 不行”“那里为什么转换后结果不同”“这个特性为什么只支持 Typst”.这种解释成本, 本质上正是系统一致性已经被破坏的证明.
更重要的是, Typst 并不只是另一种标记语法; 它本身就是一套更完整的内容表达与排版语言.若一个 SSG 以 Typst 为根基, 那么内容, 结构, 组件, 模板, 样式, 本应共享同一种语法与同一种思维方式.作者写正文时使用 Typst, 定义组件时使用 Typst, 组织页面时使用 Typst, 扩展功能时仍使用 Typst; 这才构成一个真正内聚的系统.若在入口处放进 Markdown, 便等于承认最核心的写作层不属于这套语言自身, 而只是借道进入.如此一来, Typst 就不再是系统的基础, 而只是渲染终点; 系统内部也因此失去了“从书写到生成都说同一种语言”的完整性.
从一致性的角度看, 拒绝 Markdown, 其实是在拒绝一种常见却懒惰的折中: 为了降低迁移门槛, 而牺牲语言边界; 为了照顾旧习惯, 而削弱系统自身的清晰性.一个真正围绕 Typst 构建的 SSG, 理应让用户明确知道: 这里的内容不是“先随便写成别的, 再被翻译过来”, 而是从一开始就直接存在于 Typst 的世界里.只有这样, 语法, 语义, 能力与实现才能彼此对齐, 形成统一的心智模型.
因此, 基于 Typst 的 SSG 不支持 Markdown, 并不是“不够友好”, 而是拒绝让系统沦为多套语法拼接而成的折衷产物.它所维护的, 不只是实现上的简洁, 更是语言上的主权, 结构上的纯度, 以及整个生成流程自始至终的统一性.
简言之:既然选择了 Typst 作为根语言,就不应再让 Markdown 以“兼容性”之名,在入口处重新分裂系统.
5.2 为什么typsite不接入 vue/vite | react 等框架?
一句话就是对于typst来说完全没必要
5.2.1 Vue/Vite | React 能提供什么?
- 可复用性的组件(Components are great for reusable UI)
- 可交互式的内容(Contents are interactive)
- 庞大的社区
5.2.1.1 可复用组件?
对于typsite, 去做typst的组件化处理完全是天经地义的,甚至就typst本身来说————通过声明一些函数就能很好的完成组件化任务;不过,typsite要提供的是自动style/scripts导入与去重.
5.2.1.2 可交互内容?
对于一款 SSG 来说,我们真的有必要加入可交互的内容吗?甚至不惜引入一个臃肿的运行时来增大包体积? , SSG 的首要职责,从来不是在浏览器里再造一个小型应用程序,而是把内容尽可能直接,尽可能稳定地交付给用户.文章, 文档, 笔记, 索引页,这些页面的核心价值在于“阅读”与“检索”,而不是在客户端重新执行一整套组件树, 状态系统与 hydration 过程.若一个页面百分之九十的区域只是静态文本与链接,却仍要求用户为那极少数交互承担整套运行时的下载, 解析与执行成本,这本身就是一种本末倒置
更严重的是,一旦引入 React / Vite 这一类面向前端应用开发的体系,SSG 的重心便会悄然偏移:原本应当围绕“内容组织, 生成速度, 输出体积, 可移植性, 长期稳定性”展开的设计,开始被“组件拆分, 客户端状态, 路由水合, 构建链兼容性, 依赖升级”所支配.最后你得到的往往不再是一个纯粹的静态站点生成器,而是一个假装自己是 SSG 的前端工程脚手架
所谓“可交互内容”也常常被夸大.绝大多数站点真正需要的交互,无非是目录展开, 主题切换, 站内搜索, 代码块复制, 局部注释, 少量筛选.这些功能完全可以通过原生 JavaScript, 渐进增强,或极小规模的局部脚本实现;它们并不天然要求引入一个完整的虚拟 DOM, 组件运行时与 hydration 机制.若为了一个深色模式按钮而让整站背上框架负担,那不是工程上的进步,而是对复杂性的屈服
而且,SSG 的意义本就包含一种明确的技术立场:预先生成,提前完成;
- 能在构建期解决的问题,就不要留到运行期;
- 能输出为纯 HTML/CSS 的内容,就不要强行包装成客户端组件
因此,真正合理的原则应当是:交互应当是局部的、可选的、后附的增强;而不是整个 SSG 架构的出发点.
5.2.1.3 庞大的社区?
我们typst-universe的生态可是勃勃生机,万物竞发!
《关于莉莉周的一切》
[all-about-lily-chou-chou]
- 2026-04-04 11:43
- Glomzzz
- 2026-04-04 11:43
- Glomzzz
有时,重听《月光曲》和《Rêverie》,我们会以为自己落泪,是因为想起了一年前的人和事.可音乐唤回的,是那个曾经借由这些人和事才得以成立的自己.让人痛的是,我们突然发现自己早已变了,当初的自己却并未消失.它像一道裂缝,藏在今天的生活里,等一个偶然的声音将它重新打开.
眼泪并不证明我们还困在过去.过去从未真正过去,它早已成了我们理解世界、幸福与失去的方式.我们哀悼的不只是某个人、某段时光,还有那套曾经让世界显得尚可栖居的幻象.旋律再次响起时,我们赖以维持日常生活的那层坚硬外壳忽然裂开.我们不得不承认,击中自己的并非音乐有多悲伤,而是那个曾经相信纯净之物真实存在的自己,借着音乐短暂地活了过来.
《关于莉莉周的一切》触及的,也不只是青春的残酷.它追问的是:在充满暴力、羞辱与空洞的现实里,人为什么仍然需要把某种声音、某个名字、某种无法触及的纯粹之物,安放在心里,仿佛一种“以太”?
人并不是先有了希望,才得以活下去.我们往往必须要先虚构出一个足以承载欲望的对象,才能在破碎的现实里勉强维持自身.《莉莉周》的残忍与温柔都在这里:救赎有时并不意味着现实真的变好了,而是身处废墟,我们仍没有完全失去聆听那一点以太的能力.
Rêverie and Clair de Lune
神圣哀悼之精神
[on-sacred-mourning]
- 2026-05-04 12:05
- Glomzzz
- 2026-05-04 12:05
- Glomzzz
Yorushika - Hitchcock (Re-Recording)
本文原打算在五四青年节当天发表,奈何周末 6 个作业到截止日期,只好忙完迟一天发布.
在开始阅读本文之前,你首先要清楚,我撰写此文的目的绝对不是吹捧神圣哀悼.我所写的是一种姿态、一种精神.请绝对不要在读完后神化这位知乎答主,不然你相当于白读了,他目前两百多篇回答与文章,还有我耗费数天心血写下的这篇文字,在你这里都会变成废话.
以及,如果你是哲学初学者,请不要太早学他的攻击性语气,不要太早学他把现实迅速黑格尔化,更不要如我上面所说把他当偶像.
退场时的底色
“神圣哀悼”是什么意思?这个账号的持有者只在停更声明的角落里解释过一次:“人唯有作为哀悼的对象,才具有片刻的神圣性,因为哀悼本身是神圣的——它承载着人作为有限者面对时间长河而奋起反抗时的那份悲恸与激情.”恰恰是退场时的这句话,比任何高调的宣言都更能显出他的底色:他始终在有限与崇高、绝望与激情之间,在系统性的哲学推演与尖锐的日常批评之间,绷着一股极难归类的张力.
要理解神圣哀悼,不能只把他看作一个“知乎哲学答主”.他是黑格尔–拉康–齐泽克理论脉络在中国的本土实践者(见后文),是欧陆哲学的普及者、“网哲”文化的严厉批判者,也是那个会认真回复中学生来信的人.他的文字有时像学术论文般引经据典,有时又像街头锐评般粗粝直白;他能逐层拆解梅亚苏的《有限性之后》,也能用一句话骂醒沉溺于存在主义自恋的文青.这种撕裂感并非风格上的瑕疵,而是其哲学立场在写作中的自然延伸——他的辩证法远不是教科书上死板的教条,而是一种时刻在自我否定、在文本与生活之间往复运动的活方法.
这篇阅读笔记想勾勒的,正是这种精神的轮廓:记录一个在当代中国互联网上以哲学为武器、为药方、也为哀悼仪式的人,究竟在做什么.(从某种符号意义上说,“神圣哀悼”已经死了——除了“八方来哲”的评论外,他不再回答问题,也不再更新内容;而我在这里做的,则是哀悼——有的人死了,但他还活着.)
拒绝静止的辩证法
神圣哀悼最核心的思想武器是黑格尔辩证法——但如前所述,这不是教科书里“正反合”那种粗糙的机械模板,而是经过科耶夫、伊波利特、拉康和齐泽克层层中介后的辩证法.在他笔下,辩证法首先意味着拒绝一切静止的分类学.
这集中体现在他对“社资二重性”的论述里.面对“当下中国究竟是社会主义还是资本主义”这个争论不休的问题,神圣哀悼没有选边站,而是给出了一个高度辩证的结论:两者同时成立.“CN是全世界最大的社会主义国家”与“CN是全世界最大的资本主义国家”这两个命题无需分开论述.这种二重性不是折中,而是严格遵循黑格尔“同一与差异的同一”的逻辑——社会主义与资本主义在当代中国的共存,是内在的互相规定.先锋队通过资本主义构筑国家共同体,以承担日常社会生活的再生产任务;而社会主义传统作为一种“约束”始终在场——“在今天的CN,没有人敢在公共场域下直接诋毁共产主义.”
这种分析方式贯穿他的全部写作.评论未明子的实践困境时,他看到的是“前现代与后现代”两面包夹下一个辩证法家的受挫;讨论“全女经济”的速朽时,他读出了文化左翼将理论传播寄托于网络媒介这一策略本身的“反辩证法”性质——“那些试图通过网络动员来实现‘女性觉醒’的文化左翼,从一开始就踏入了一个必败的陷阱:他们使用的工具(流量媒体),其底层逻辑恰恰是瓦解辩证法、否定性、主体间性以及政治现实性的.”在这里,辩证法既是分析工具,也是诊断工具:当传播技术本身只能流通“平滑而刺激的符号”时,任何批判性思想都会被中介物自身的逻辑扭曲.这就是他所说的“中介间性”——媒介不再是透明的工具,而演变成高强度自我再生产的普遍性实体.
他的辩证法还有一个关键特征:历史感.他反复强调辩证法本身处于运动之中,“辩证法之辩证法”意味着辩证法也在不断扬弃自身.毛泽东的对立统一辩证法在特定时代取得过巨大成功,却在文化大革命的历史语境下显出局限——“对立统一辩证法的失败,恰恰意味着新的辩证法的到来.”因为始终对方法本身保持反思,他的写作没有停留在单纯的立场宣示,而是真正进入了哲学实践.
“二十一世纪精神病”与网哲幻象
如果说辩证法是神圣哀悼的方法论内核,那么对“网哲”现象的持续批判则是他最醒目的公共面向.他花了大量篇幅解剖当代中文互联网上哲学话语的生产与消费机制,切中要害.
其中一个经典诊断,是剖析中学生如何用大语言模型(LLM)炮制“原创哲学体系”:“他们的自恋需求迫使自己需要别人来理解、赞美,于是他们有了一个绝妙的移情对象——人工智能.”经过对齐训练的 LLM 面对预设了立场与前提的提示词,会“用尽一切手段扭曲数据库中的信息文本来提供各种支撑,给予中学生一种自己能够并且正在同哲学史、科学界乃至社会现实对话的错觉”.在这背后,是他对这类人群更深的一层观察:他们的问题意识很薄弱,关键词翻来覆去逃不出“本质”“意义”“自由”这几个基础概念,而欧陆哲学史早已把这些问题处理得极为深入.他们既缺乏消化外来知识的能力与习惯,又迫切渴望获得承认——LLM 恰好填补了这个空洞.神圣哀悼把这种现象称作“二十一世纪精神病”:在日益原子化的社会里,个体在现实中得不到承认,便转而通过几乎零成本的 LLM 来喂养这种欲求.
他对“网哲”的批判并不止于中学生,对圈内的“智性等级制”同样不留情面:“互相辱骂、互相开盒、互相发骚扰短信”的“网斗”,以读最冷门的哲学为荣的“智力竞赛冠军”,以及那些“寄生于哲学家并以此鄙视他人获得优越感”的“大手”.这些批评与其说是道德谴责,不如说是现象学白描:当哲学从“指导我们面对和处理现实生活的操作方案”,退化为“从现实退入哲学,在一系列人名、书名中逃避现实”时,它就已经背叛了自己最根本的任务.
往深处看,他对网哲文化的批判与其服膺的黑格尔–拉康传统一脉相承.拉康说“大他者不存在”——世上没有一个绝对权威能为一切作保.可网哲圈的运转机制却在不断制造新的“大他者”:无论是被奉若神明的圈内“哲人王”,还是有求必应、提供虚假肯定的 LLM,都篡取了那个本不该存在的位置.因此,他的批判最终指向一个拉康式的伦理要求:穿越幻想,直面大他者的匮乏,自己为自己的欲望负责.
把哲学拉回地面
光有诊断还不够.神圣哀悼的文字里始终带着强烈的实践关切,这让他和那些只在象牙塔里玩弄概念游戏的学者拉开了距离.他一再强调,“哲学首先应该能够构成指导我们面对和处理现实生活的操作方案”.这种关切在他写给求助者的回复里最为直接.
曾有一位高一学生在知乎倾诉:自己当过“网左”和“网哲”,读了不少书、成天泡在黑话里,却在省重点高中的高压下陷入厌学,甚至出现头痛和幻听.神圣哀悼没有甩半句哲学黑话,反而给出了极其具体的建议:“把所有网左QQ群退了”,先读近代哲学打基础,把身体养好,“认真学习,看看自己对什么行业或工作感兴趣,规划好未来的专业和生涯,确保自己毕业之后有路可走”.他还写道:“如果你是(或者说你想成为)社会主义的有生力量,就要爱惜自己的身心健康与社会生命,要爱惜自己手中那微末而宝贵的‘未来可能性’,要能够自食其力,能够照顾好自己身边的人,这样才能具有真正的组织力、行动力.”
这段话把哲学从半空拉回了地面.辩证法的否定性绝不只是书本上的抽象概念,它首先意味着对自己过往病态生活方式的扬弃;与其在 QQ 群里复读列宁主义口号,不如在日常里践行“自食其力、照顾好身边人、培养组织力”的修行.在这里,哲学回到了它最初承诺要做的事:帮人更好地活着.
这种务实的底色贯穿了他的写作.谈教育和就业时,他不像是在高处颁布真理,更像一个趟过足够多泥潭的过来人在给建议;谈左翼实践时,他毫不避讳“无组织无纪律的民粹活动”的虚妄,直言那是“对你的宝贵生命的浪费”;批评存在主义文青的“清醒而痛苦”时,话虽然说得刻薄,底子里却透着一股“见过太多同类人”的无奈——“其实我在这里攻击你,也是你享乐的一环.”
这也解释了他最终为什么离开知乎.当他说“该说且能说的都说完了”、“知乎盐粒计算有一定问题,很多产出的收入不翼而飞”时,背后同样有一层实践逻辑:如果写作不能再有效介入现实,继续写下去就只剩自恋的再生产.他很清楚,停留在“阐释”层面的哲学话语终究会被资本的符号机器收编——与其沦为平台景观的一部分,不如适时闭嘴.
打破幻想的伦理
神圣哀悼最让人印象深刻的特征之一,是他的尖锐.他骂教科书式的马列主义是“挠餐哲学”,说高中政治课本是“垃圾”,称沉溺于自创哲学的中学生“闹麻了”,对贩卖庸俗哲学课的董宇辉之流更是毫不留情.在讲究温良恭俭让的中文互联网上,这种语风显得格外扎眼.
但如果只把这当成“脾气臭”,就错过了他身上最可贵的东西.他的尖锐,与德勒兹对哲学的著名定义一脉相承.他曾多次引用这段话:
“当有人问‘哲学有什么用?’这个问题时,回答必须富有攻击性,因为对方试图以尖酸刻薄的语气发问.哲学并非为国家或宗教服务……哲学的作用在于使人悲哀(La philosophie sert à attrister).如果某种哲学从未使人感到过悲哀或苦恼,那么它就不是哲学.哲学有助于减少愚昧,令愚昧成为一种耻辱.它的惟一用途在于暴露思想的一切卑贱形式.”(德勒兹《尼采与哲学》)
这段话是他写作伦理的基石.在他看来,用温柔、不伤人的话术去哄着思想的卑贱形式,不叫宽容或同情,而叫“共谋”.当一个人用“我是回避型人格”为自己的冷暴力开脱,用“存在先于本质”为不负责任找借口,用“没有绝对的对错”来消解一切价值判断时,对他们的纵容绝不是善意,而是对思想本身的侮辱.面对这些自我安慰的肥皂泡,神圣哀悼选择直接戳破.
尖锐不代表冷血.看看他写给那位因分手而痛苦的女性题主的回复:他既点出了女方拿“不给做饭”来施压的幼稚,也批评了男方动辄扣“极端女权”帽子的粗暴,随后借用主奴辩证法与意识形态再生产,给出了一个比绝大多数情感博主都透彻的分析框架.最后他写道:“就怕到最后题主产生了类似于‘好啊,你觉得我是女权,那我现在就要站在波伏娃那边审判你的父权制!’之类的挠餐想法……这比一般意义上的分手更可怕,它让两个人变成两个蠢货.”话依然辛辣,但关切是实打实的:他不希望这两个人被情绪和流行话术裹挟,最后变成“两个蠢货”.在这里,批判本身就是一种难得的尊重——正因为他把对方当作有理性、有能力反思自身的成年人,才不屑于用廉价的共情和空洞的安慰去糊弄对方.在他眼里,哄小孩式的抚慰才是真正的轻蔑.
这种姿态也体现在他划定边界的时候.他曾回复一位中学生,直言自己花时间读完对方的“原创哲学体系”后,发现“毫无营养、毫无价值、毫无内容”,因此拒绝继续交流:“为了节省个人精力、时间,也为了节省公共资源,之后不再对上述事件给出任何回应.也希望有类似自恋需求的中学生不要再给我发原创哲学体系,这段时间本人越来越忙,实际上没时间哄小孩的.”这记闭门羹本身就是一堂哲学课:你的思想若想赢得他人的承认,就必须经受严肃的审视,而不是伸手讨要廉价的夸奖.
"梯子"
然而,就在这种尖锐与拒绝的另一面,神圣哀悼却做了一件让人有些意外的事:发起“八方来哲”项目.项目的规则很简单:无论年龄、学历、性别、地域,只要有原创的哲学构思,谁都可以向他投稿,他会公开回复并给出评议.
这看似与他对“民哲中学生”的痛批自相矛盾,实则界限分明.在项目公告里,他把丑话说在了前头:投稿必须表意清晰、行文流畅、严格围绕哲学议题——“如信件往来中出现无关哲学的内容,譬如童年创伤、学历自卑、政治敏感、精神病发作等情况,本人有权不给予任何回应且不公开信件.”换言之,他反感的从来不是民间哲学思考本身,而是把哲学当成自恋道具或情绪垃圾桶.对于那些“果有才能、态度真诚、只是受限于国内贫乏哲学资源而难以进步”的人,他从不吝惜时间和精力.
翻看已经发布的三期“八方来哲”,他对来稿的评议相当认真、公允.面对一篇探讨鲁迅的稿件,他建议引入鲁迅思想的时间轴,将“竹内好、汪晖 vs. 丸山昇”的争论格局同构为“早期鲁迅 vs. 晚期鲁迅”;面对一篇试图总结伦理道德发展规律的稿件,他挑明了其中三个核心前提的内在矛盾,直言“本文虽然挪用了马克思主义的一些关键词,但缺乏对马克思主义的辩证法以及政治经济学的深入理解和吸纳”;而面对一篇剖析“全女经济”的文章,他不仅指出了原有分析的盲区,还顺手搭建了一整套关于“中介间性”的理论框架——那位作者若是真把这段长评消化了,收获恐怕抵得上好几门大学课程.
这就是他所说的“梯子”.他在一篇自我介绍里写过:“我的回答是且只是一个梯子,并不能让读者‘学会哲学’.想要学会哲学,一方面需要花时间去阅读,另一方面需要在自己的现实生活中应用哲学,用哲学来调整自己的生存姿态.”梯子不是终点,甚至不是必需品;但如果有人在向上攀爬时刚好需要借一把力,他愿意当这个借力的支点.人爬上去了,梯子大可以扔掉.
这种自我定位,贴合他对哲学的根本理解:哲学不是一套可以打包占有的知识体系,谁也无法像背书一样“学会”它;哲学是一种需要在生活里不断操练的姿态.他能做的,无非是指几个入口、画几张路线图、立几块警示牌.剩下的路,得靠每个人自己去走.
即使注定失败
人在哀悼中确认逝者的不可挽回,确认时间的一去不返,也确认自己面对这一切时的无能为力;可恰恰是在这种确认里,人拒绝遗忘,拒绝把逝者当作从未存在过.这种拒绝改变不了任何既成事实,却守住了人的尊严:人是明知徒劳、却依然选择铭记的生物.
神圣哀悼的全部写作,未尝不是一场漫长的哀悼仪式.他哀悼的,是在互联网时代被符号消费与算法推荐碾碎的思想严肃性;是被应试教育、优绩主义与庸俗成功学憋死在半路的青年生命力;也是上世纪的社会主义实践及其遗产——“CR没有失败,反而以一种独特的方式实现了其目的.”这种哀悼不是伤春悲秋的怀旧,而是一种主动的铭记:记住那些曾经敞开过的历史可能性,让它们在当下的实践里继续在场.
德勒兹说哲学的作用在于“暴露思想的一切卑贱形式”.神圣哀悼接过了这个任务,但没有止步于拆穿:在撕下种种卑贱伪装的同时,他也始终为那些还没被彻底碾碎的可能性留着一方空间——一个认真对待哲学的学生、一个真诚想要理解世界的读者、一个在生活泥淖里依然寻找出路的人.这绝不是廉价的乐观主义,而是比乐观主义艰难得多的选择:看清一切注定失败的结局之后,依然去做那些值得做的事.
这就是我理解的“神圣哀悼之精神”:深知真理的沉重、思想的艰难与行动的有限,却依然坚持思考、拒绝犬儒.它不兜售安慰,不许诺胜利,也不迎合自恋.它只做一件事:告诉你,你并不特殊,你的迷茫与痛苦前人早已尝过,并且用深刻得多的方式面对过;然后,如果你愿意,它可以陪你走上一小段.
至于剩下的路,你得自己走.
读完神圣哀悼的所有文字,一个问题自然会浮现出来:看穿了意识形态的虚妄、诊断了自恋的病理、也认清了文化左翼的困局之后——我们还能做什么?
他的回答散落在各篇文字里,拼合起来大致是三条朴素的路径:
首先是诚实.坦然承认自己身上的矛盾,承认自己同样被资本主义意识形态所俘获,承认自身的有限性.“我其实是一个保守、退步、落后、被资本主义意识形态俘获的人,但我仍然愿意去学习思考社会主义,这难道不是对辩证法最好的注解吗?”
其次是行动.比起悬浮在半空的宏大革命叙事,我们更需要切近的、日常的、从自身出发的行动——扎实学一门手艺或专业,照顾好身边的人,在自己的本职工作中守住对弱者的关怀.
最后是团结.纯粹建立在抽象理念上的同盟极易瓦解,真正稳固的团结只能生长于共同生活之中.哪怕是一起踢球、出游、组织演出,只要能让原子化的个人重新在现实中结成有机的联结,就有其意义.
这些建议听起来平淡无奇,远不如一句“打倒资本主义”来得痛快.但恰恰是这种平淡,构成了神圣哀悼之精神的落脚点:当崇高的宏大叙事显露出脆弱与裂痕时,依然选择在具体的现实里去行动、去爱、去创造——不是因为这样做必然会赢,而是因为行动本身就是对虚无的回答.
加缪说,应当想象西西弗斯是幸福的.神圣哀悼大概会说,不必靠想象——只要你在推石上山的过程中,真切地摸到了自己生命的重量与温度,那就够了.
这也是为什么他会取名“神圣哀悼”:哀悼之所以神圣,不在于被哀悼的对象有多神圣,而在于哀悼这一行动本身,承载了有限的人面对无限时间时那份徒劳却悲壮的反抗.人终有一死,但正是在这短暂的途程里,我们曾认真地思考过、真诚地爱过、也为了某些东西奋起反抗过.
谨以此文,献给所有尚在迷途中的青年,以及我自己.
参考文献
- 黑格尔, G. W. F. (2019). 《精神现象学》 (先刚 译). 人民出版社. (原著出版于 1807)
- 科耶夫, A. (2013). 《黑格尔导读》 (姜志辉 译). 译林出版社. (原著出版于 1947)
- 伊波利特, J. (2014). 《黑格尔〈精神现象学〉的生成与结构》 (王立秋、严和来 译). 中国人民大学出版社. (原著出版于 1946)
- 拉康, J. (2001). 《拉康选集》 (褚孝泉 译). 上海三联书店. (原著出版于 1966)
- 齐泽克, S. (2002). 《意识形态的崇高客体》 (季广茂 译). 中央编译出版社. (原著出版于 1989)
- 德勒兹, G. (2001). 《尼采与哲学》 (周颖、刘玉宇 译). 社会科学文献出版社. (原著出版于 1962)
- 梅亚苏, Q. (2018). 《有限性之后:论偶然性的必然性》 (吴燕 译). 河南大学出版社. (原著出版于 2006)
- 加缪, A. (2010). 《西西弗神话》 (沈志明 译). 译林出版社. (原著出版于 1942)
- 波伏娃, S. de. (2011). 《第二性》 (郑克鲁 译). 上海译文出版社. (原著出版于 1949)
- 毛泽东. (1991). 《矛盾论》. 载于《毛泽东选集》(第一卷). 人民出版社. (原著写于 1937)
- 神圣哀悼. 《本账号的运营,也终于走到宣告完结的时刻》. 知乎. https://zhuanlan.zhihu.com/p/1968960896186425344
- 神圣哀悼. 《Socialism与Capitalism的二重性 | 黑格尔派Marxism辩证法的重要结论》. 知乎. https://zhuanlan.zhihu.com/p/668211770
- 神圣哀悼. 《【八方来哲 第3期】中介间性的到来与文化左翼的末路》. 知乎. https://zhuanlan.zhihu.com/p/1998323606325843625
- 神圣哀悼. 《为什么有那么多自称13~19岁的人人在知乎上的问题都是,愿意把自己的中二病幻想,称为某某的哲学理论?》. 知乎. https://www.zhihu.com/question/1967584565175486141/answer/1967921529724605647
- 神圣哀悼. 《网哲、我的哲学观以及我运营知乎的原因》. 知乎. https://zhuanlan.zhihu.com/p/10144610680
- 神圣哀悼. 《当代青年学生应该干什么?》. 知乎. https://www.zhihu.com/question/1958661563343958838/answer/1958830095394407087
- 神圣哀悼. 《因为活得太清醒而痛苦如何是好?》. 知乎. https://www.zhihu.com/question/1893038099237430206/answer/1893227702682634061
- 神圣哀悼. 《什么是哲学?》. 知乎. https://www.zhihu.com/question/6301611838/answer/51281395398
- 神圣哀悼. 《跟男友吵架了,感觉男友对我已经有刻板印象了,对关系感到紧张迷茫,怎么办?》. 知乎. https://www.zhihu.com/question/1957963545611338663/answer/1958558230344099729
- 神圣哀悼. 《回应〈评“神圣哀悼”〉以及有志青年走出自恋症状的三种方法》. 知乎. https://zhuanlan.zhihu.com/p/1907502125862355043
- 神圣哀悼. 《【八方来哲】诚意广征原创哲学构思》. 知乎. https://zhuanlan.zhihu.com/p/1968258888429212980
- 神圣哀悼. 《【八方来哲 第2期】研究马克思主义一定要研究马克思.》. 知乎. https://zhuanlan.zhihu.com/p/1987215498258186257
- 神圣哀悼. 《左派为什么这么喜欢强调吃苦?》. 知乎. https://www.zhihu.com/question/1892307695861740625/answer/1892877412808762901
评<<奥德赛>>
[when-it-comes-to-odyssey]
- 2026-08-01 04:19
- Glomzzz
- 2026-08-01 04:19
- Glomzzz
Legend of the Eagle Bearer (Main Theme)
(含剧透)
<<奥德赛>>作为诺兰的一部改编电影,依旧有着浓厚的诺兰味儿:充满对称性的叙事与无数的前后呼应来让碎片化叙事呈现出奇幻的一致性(甚至每一个关键转场都伴随着或是音效或是动作或是比拟的连续性),最令我印象深刻的是Odysseus拨动弓弦这一简单的动作,弓弦被拨动时发出的清脆弦声荡气回肠,在电影的每一部分,这弦声都代表着荣耀的伊塔刻之王的骄傲,Odysseus即使在狩猎时也要拨动弓弦让猎物与之正面对抗(而非偷袭,虽然这会让猎物逃跑但这正能体现他出色的弓术),而他将弓上弦拨动并射箭这一气呵成的动作便是Odysseus的标志:
Penelope announces in her long interview with the disguised hero that whoever can string Odysseus’s rigid bow and shoot an arrow through twelve axe shafts may have her hand. (这当然也是一大前后呼应)
IMAX体验真的非常好,音效绝了,(但中间长达几分钟的电闪雷鸣让整个放映厅的亮度发生极端且快速高频的变化快给我看吐了只能眯眼好几分钟,真得复读童子军大王了);作为一个文化作品,<<奥德赛>>无疑是无比经典的,它就是西方文学之源<<荷马史诗>>改编而来的,而就观感来说这无比经典的故事无疑是一大败笔(虽然无可厚非),你能看到你早已在其它作品里或见过或听过无数次的西方奇幻元素——住在山洞里养羊的独眼巨人,将吃下神秘肉的的人变成他们原始冲动般的牲畜,在礁石上歌唱并诱惑水手的海妖……(这简直就是冰与火之歌,哦我西方龙呢?),这确实会让被西方神话洗礼过的现代观众有点审美疲劳了,但好在IMAX体验非常不错还是有点说法的(独眼巨人洞穴那一段的压迫感,女巫将饥肠辘辘,狼吞虎咽的士兵们捏成一个个牲畜时的紧迫感,以及耳朵塞上蜂蜡也抵挡不住海妖那迷人的歌声等等……
提到音效,这部电影完全没有一个像诺兰其它著名电影如<<奥本海默>>,<<星际穿越>>里那种有着非常抓耳旋律的主题音乐,which非常非常可惜;
最后来一波神圣哀悼最擅长的——把一切文化现象塞进“资本主义符号秩序”的棺材板里:Odysseus沦为反抗“神定命运”的”提线木偶“,十年返乡路被抽干了历史性与阶级矛盾,只剩绝对精神在资本主义符号秩序里空转.172分钟的奇观,是辩证法的葬礼——一切反叛都被高阶资本提前预支,这是绝对精神在自我循环中的一次漫长叹息,对了,连叹息都是杜比全景声的(以及我的膀胱的)——不得不说这何尝不是一大”景观“.
评<<无职转生>>
[on-mushoku-tensei]
- 2026-09-21 02:09
- Glomzzz
- 2026-09-21 02:09
- Glomzzz
古希腊悲剧强调人与不可抗命运的对立,其核心机制是hamartia(悲剧性缺陷)导致的因果链:人物性格决定行动,行动引发后果,后果导向毁灭.这个东西在现如今几乎所有的影视文学作品中都有涉及,人物的hamartia基本来源于创伤童年、求学时的重大挫折、成年后的巨大家庭变故等等,由此,衍生出其行为逻辑的必然和不可逆.
鲁迪乌斯的灵魂仍然是那个三十多岁的尼特族,如果背景设定不是一个充满着无限可能的魔法世界(存在时间魔法这种改变规则的东西),老鲁迪线基本上是必然,只是时间早晚的问题.理不尽的文字虽然简单,但此人绝对是饱读文学作品的,对人物的刻画还有故事架构这方面水平相当高,我看其他的小说顶多会觉得“这故事写得真好”,但看无职就有种他在讲他身边发生的真事的感觉;另外小说中的每个角色无一例外都被塑造的非常具体,他们首先是一个个活生生的人,其次才是服务于小说情节发展的角色.
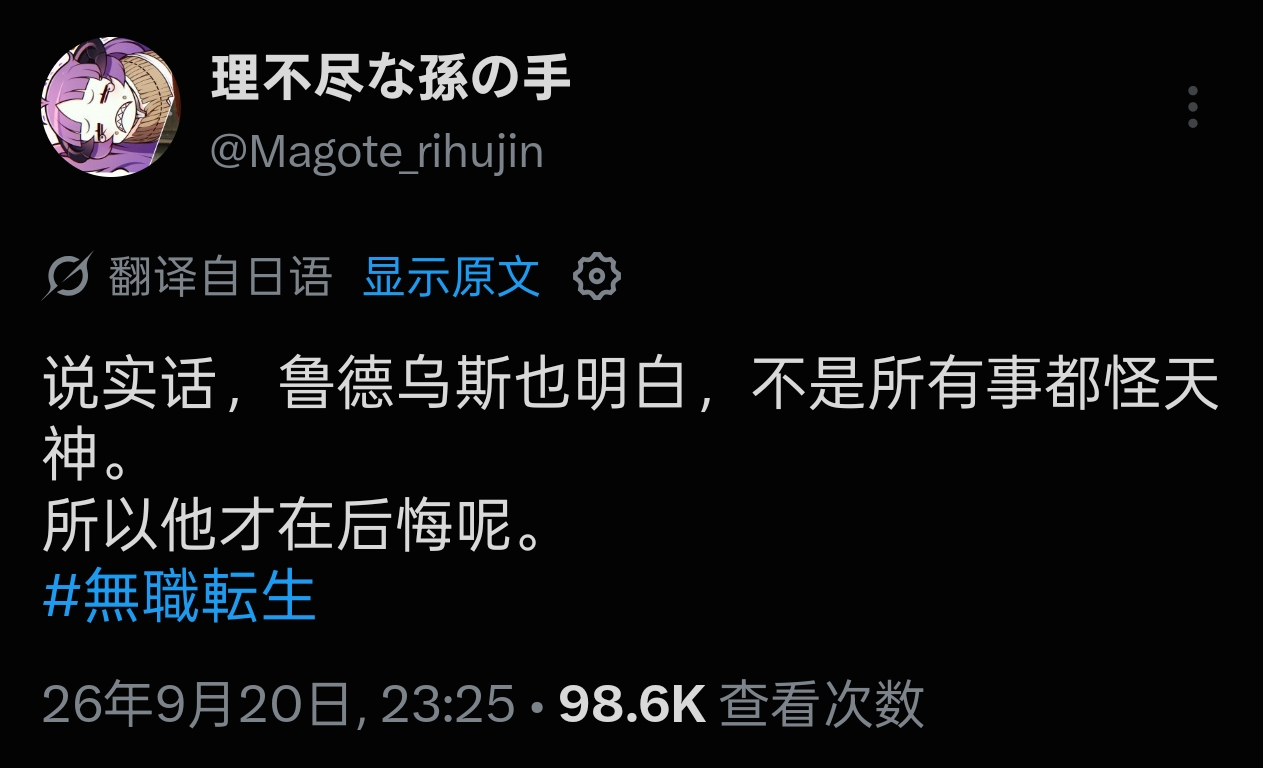
如果从另一方面来说,无职中的悲剧,它的形式是将“有价值之物”毁灭给人看,而其的手法又是通过描写失去来让人感受到“拥有之物”的重量,作者无疑是懂得怎么来最刀的(让我想起了上校摸冰的那个下午)
日记篇的精彩与高明之处在于,以第一人称的叙事方式给予读者感官上的震撼的同时,结合悲剧性预知穿插着普通日常带给读者的反差性冲击,这种强烈的反差对照让读者自己自行就和主角产生共情;日常篇的所有故事线都在日记篇收束:帮爱丽儿夺取王位的结局,在迷宫中被勇者所救并过上了幸福生活的结局,练剑只为了站在心爱之人旁边的结局,一心只想照顾好哥哥的结局,夺取主教之位的结局,坚持数十年只为回到家乡的结局...
以及每位角色的死其实都是有考究的,十分反差:最怕火却被火烧死,最拮据生活的人却因此染病,最想保护别人却始终不被信任,最讨厌废物的却对废物不离不弃,最虔诚信教却被宗教所杀,最思念故乡的却无法回到故乡...
小说手法上非常典型的“让读者完成动机”,比单纯的描绘悲惨未来要震撼百倍又深刻百倍.上次能带给我类似感动的应该是石头门
动画则是直接一口气把完整的老鲁迪线讲完了,不得不说节奏很紧凑但是情绪渲染太到位了,和当初看小说时的想象几乎如出一辙.
drama, absolute cinema, 这就是为啥古往今来悲剧这么吸引人,太美味啦(x)
寻径
[index]
- 2026-08-14
- Glomzzz
生命不熄,控制终将失灵.
- 2026-08-14
- Glomzzz
编程语言理论
[index]
- 2026-10-08
- Glomzzz
程序语言理论(PLT)
- 2026-10-08
- Glomzzz
这里收集成体系的程序语言理论(PLT)文章.
初入编程语言理论
[intro]
- 2026-10-08
- Glomzzz
为什么迷上程序语言理论,它的复杂度从何而来,以及给初学者的入门路线.
- 2026-10-08
- Glomzzz
程序语言理论(PLT)大概是我人生中少有的、能让我持续感兴趣的东西. 它对我的吸引力不太像“一门学问”,更像一种手感: 手里有一套可以自己制定的规则,而要做的事,是让这套规则在某个地方真正跑起来. 这篇文章想聊三件事:我为什么会迷上它,它到底难在哪里, 以及如果今天让我重新入门,我会怎么走.
1 从简陋的计算器说起
起点是我用 Rust 写的计算器. 它简陋到只有四个运算符,加上括号,能跑. 但当我第一次意识到
1 + 2 * 3
1 + 2 * 3
并不该按从左到右解释时, 就撞上了第一堵墙:运算符优先级. 为了越过它,我读了 matklad 的 Simple but Powerful Pratt Parsing, 第一次知道原来“解析”本身是一门可以设计、可以品味的技艺: 每个运算符有自己的结合力,前缀、中缀、后缀各有一套处理方式, 几十行代码就能支撑起可扩展的表达式文法. 那大概是我第一次感受到“抽象”带来的直接快感.
后来我在 JVM 上折腾了一段时间. JVM 对动态语言相当友好:反射、字节码生成(ASM 与 ByteBuddy)、 动态代理、成熟的即时编译(JIT)与垃圾回收(GC),全都现成. 于是我给 Minecraft 服务器写了一些领域特定语言(DSL), 让服主可以用接近自然语言的方式描述规则. 也是从这里开始,我接触了后端优化: 为什么同样的逻辑,换个写法性能会差一个数量级? 答案往往不在写出来的那几行代码里,而在 JIT 的视角里: 这段代码会怎样内联、怎样做逃逸分析、怎样做去虚拟化.
再往后是偶然的连锁反应. 我在尝试对柯里化函数做部分应用时,冒出一个念头: 与其每次调用都重新组合参数,能不能在编译期尽量把已知的部分算出来? 顺着这条线,我遇到了部分求值与 Futamura 投影, 又遇到了多阶段编程(如 MetaOCaml 与 LMS), 再往下就是计算作用,以及描述它们的静态作用系统、 建模它们的单子(Monad)、解释它们的代数作用处理器…… 每一样都通向更大的世界,我至今也没走完.
上了大学之后,能自由折腾的时间突然变少了. 大一为了应付作业,我读了 Abelson 与 Sussman 的 Structure and Interpretation of Computer Programs (《计算机程序的构造和解释》,简称 SICP), 然后用 C++ 写了 Scheme 解释器, 那大概是我第一次完整走完“读语法 → 求值 → 打印”这一圈. 这学期我选了一门编程范式的课,又写了半个学期的 Haskell, 大作业是用 Haskell 写解析器组合子,突然就找回了当年那种感觉.
1.1 所以,到底为什么喜欢?
我也问过自己很多次. 答案大概是:PLT 是少数几个“你既是规则的制定者,又是规则的囚徒”的领域. 你设计一套语言,然后必须接受自己设计出来的一切后果, 包括那些在设计时根本没想到的交互. 这种“造物”与“遭造物反噬”之间的张力,对我有很强的吸引力.
另一方面,它是少见的、把“抽象”当作第一公民的工程领域. 别的工程把抽象当作工具,PLT 把抽象当作研究对象本身.
2 复杂度从哪里来
我设计过不少语言的规格,但几乎每一次都因复杂度过高而作罢: 它增长得比预想的快得多. 好在这两年有了大语言模型,可以帮我填补生产力空洞: 只要把想法讲清楚,就能很快得到能跑的实验原型. 但“能跑”和“设计得对”之间,仍然隔着整个复杂度问题.
2.1 语言特性?排列组合!
语言设计的第一步,往往是决定“我要哪些特性”. 这一步很像做排列组合:你希望某些特性之间发生奇妙的化学反应, 或者为了专攻某个方向而特意引入某些特性, 例如 Rust 的仿射类型与生命周期、Haskell 的类型类、Lisp 的宏. 把这些特性两两摆到一起,大致会看到五类关系:
- 正交:彼此独立,可以放心叠加. 例如词法作用域与垃圾回收、闭包与模式匹配、泛型与模块系统; 它们各自解决不同维度的问题,组合起来几乎不产生额外语义.
- 协同:单独看平平无奇,合起来却能涌现出新能力. 例如闭包与 GC 让高阶函数变得廉价; 类型类与单态化让“零成本抽象”成为可能; 模式匹配与广义代数数据类型(GADT)支持类型安全的结构化求值; 代数作用与定界续延让“可恢复的计算”成为一等公民. 这类组合是设计语言时最值得追求的东西.
- 冗余与重叠:同一个目的有多种相互重叠的表达方式, 硬塞在一起就可能让语言出现“两套并行的世界观”. 例如 Monad 与代数作用处理器都可用于建模与组织副作用: Monad 通常以库抽象的形式组织计算, 代数作用处理器通过处理器解释作用操作; 后者既可以作为语言特性,也可以编码成库,两者在语义上有紧密联系. 再如异常与
ResultResult/EitherEither、nullnull与OptionOption、类与类型类、宏与泛型. 冗余本身不致命,但它会让用户不断面对“我该用哪个”的选择疲劳, 也会让两套机制的交互成为缺陷的温床, 因为任何一处改动,都得把所有组合重新考虑一遍. - 冲突:单独看都很好,放到一起却语义打架,或者直接导致理论上的不可判定. 例如子类型与多态、类型推理的组合会增加复杂度, 某些具体系统存在不可判定性,但仅凭子类型与记录或列表并不能推出这个结论; MLsub 与 Simple-sub 就支持子类型、记录和 ML 风格的全局类型推理. 又如类型推理加特设重载会让“最具体实例”的选择变得病态; 宏如果不满足卫生性,会污染调用处的作用域; 线性类型与“可随意复制”的默认语义天然对立. 这类组合往往必须“取舍”而不是“调和”.
- 依赖:特性 B 的成立以特性 A 为前提. 例如 GADT 模式匹配需要能处理局部类型相等约束的检查规则, 实际实现常借助显式标注; 高秩多态类型不同于高阶类型构造子, 在 GHC 等实现中通常需要标注提供多态参数的类型. 若希望依值类型承担可信证明,并保证类型检查中的计算终止, 就需要限制相关递归或验证其终止性,但不必要求所有程序都终止.
asyncasync与awaitawait则需要支持挂起与恢复的机制: 状态机变换是常见实现方案之一,也可以借助续延传递风格(CPS)、栈式协程或作用处理器. 识别真正的依赖关系、区分它们与实现选择,才能排出合理的实现顺序.
也许还该补上第六类:不可组合. 这不是“打架”,而是根本不在同一套假设下, 例如一等续延与某些 C 外部函数接口(FFI)的栈约定.
2.2 交叉点、盲点与处理方式
选好特性只是开始. 真正的复杂度来自交叉点: 个特性最多有 个两两交互, 数量只是二次增长; 如果考虑所有包含至少两个特性的子集,则共有 种可能组合, 数量是指数增长的. 不过,组合数量并不等于实际设计复杂度,还要看哪些特性真正发生交互. 你在设计 A 和 B 时都想到了各自的情况, 却没想到 A 的某个角落和 B 的某个角落会撞在一起.
盲点通常不会在纸面上暴露,而是在这些地方显现出来:
- 形式化:写出操作语义,或者在 Coq(现名 Rocq)、Agda、Lean 里做机械化证明; 代价最高,也最彻底.
- 测试:写足够大的测试套件或一致性测试,像 WebAssembly 的规格测试那样, 用大量程序去撞边界.
- 自用:拿这门语言写非平凡的程序,最理想的是自举, 把“设计者视角”换成“用户视角”.
- 实现:先写原型编译器,让类型检查器和求值器替你发现矛盾.
发现盲点之后,处理手段大致也就那么几种:
- 限制:直接禁止这个组合,例如规定“泛型不能作为数组长度”,用报错换一致性.
- 规约:把一种特性脱糖成另一种,只保留一套语义内核, 例如把
forfor脱糖成whilewhile、把asyncasync脱糖成状态机. - 分层:把两套机制放到不同的层级,规定谁能看见谁, 例如把宏展开限定在编译期,把作用的静态描述与检查放在作用系统里, 再由生成的代码或运行时机制实现对应行为.
- 引入新构造:承认“光靠已有特性表达不了”,加专门的正交构造来承担交叉点.
- 限制自动推导:要求必要的类型标注,以采用可判定的检查算法; 若检查或子类型判定本身不可判定,则标注也未必能解决, 必须另行说明限制哪些规则、如何处理无法完成判定的输入.
“该怎么发现盲点、该怎么处理盲点”,基本上就是 PLT 研究的日常, 也是语言设计复杂度的真正来源.
3 语言设计的抽象
复杂度虽然会迅速增长,我们还有抽象这一工具. 先把“语言设计”这条混沌的河切成几段相对独立的层,再逐层讨论,会清楚得多. 我个人习惯分成四层.
3.1 语法
这一层包含所有与“人怎么写、机器怎么读”有关的设计: 具体语法与抽象语法、运算符优先级与结合性、 缩进与换行规则、语法糖、宏与卫生性、错误恢复.
这一层看起来最“浅”,其实最容易积重难返: 随手加的语法糖,可能会让后续所有解析都变得含混. 经验法则是:让语法糖尽量可脱糖; 每引入一种简写,都要能说清楚它脱糖后的核心形式是什么.
3.2 中间表示
这一层包含从抽象语法树(AST)到字节码之间的所有表示及其转换: 脱糖、A-正规形式(ANF)、CPS、静态单赋值形式(SSA)、 三地址码、闭包转换、单态化、内联、优化遍.
中间表示(IR)的设计与降级流程会深刻影响语言实现: 惰性求值常用延迟块(thunk)或闭包实现,但不要求每一级 IR 都保留显式的节点; 保证尾调用不增长调用栈,需要编译流程与目标平台的配合; 可恢复的作用处理器需要相应的续延或挂起与恢复机制, 而普通的状态修改、I/O 等副作用不需要这样的机制. 很多语言最终卡住,不是因为语法或类型系统, 而是因为从核心语义到低层代码与运行时的转换没有打通. 总之,IR 是落实语言语义的重要桥梁.
3.3 检查系统
“类型系统”只是这一层的一部分,所以我更愿意叫它检查系统. 它负责拒绝那些不该通过的程序,通常在编译期完成,必要时也可以推迟到运行时:
- 类型系统:Hindley–Milner(HM)、F 系统、依值类型、 线性与仿射类型、精化类型. 实现时可采用双向类型检查: 它是一种检查的组织方式,而不是与 F 系统同层级的演算分类.
- 作用系统:作用标注、作用行、作用多态等. Monad 可用于建模作用,代数作用处理器是解释作用操作的机制, 两者不等同于静态作用系统; 有处理器的语言也未必静态跟踪作用,例如 OCaml 不静态保证所有作用都得到处理.
- 所有权与借用检查:Rust 那套基于区域与借用的静态分析.
- 终止性与全域性检查:全函数式编程这一脉.
- 其他静态性质:纯度、可序列化性、并发安全性等.
这一层的关键词是“取舍”: 表达力、可推导性、错误信息的可读性、实现复杂度,四者几乎不可能同时最优.
3.4 运行时
这一层包含程序跑起来时的一切: 内存管理(GC、自动引用计数 ARC、区域等)、副作用管理、 求值策略的实现(按值调用、按需调用、按名调用)、并发与并行模型、 FFI、解释执行与 JIT. 提前编译(AOT)是运行前的编译方式,属于编译流程; 它生成的代码仍可能依赖运行时支持. 线性与仿射类型则是静态约束,可以帮助编译器安排资源释放, 但不是运行时内存管理算法.
在我看来,这一层最工业化、最繁杂. 入门课程会覆盖其中一些概念,但生产级运行时的工程细节很难在一门课里讲透; 它也是决定一门语言能否落地的重要因素.
4 学校的 PLT 教育
学校里的程序语言教育没有统一的配方: 有的课程偏重编程范式、类型系统与语义,有的偏重编译器实现. 后一类课程常从词法分析与语法分析开始,继续讲语义分析、IR、优化与代码生成. 例如 UNSW 的研究生课程 COMP9102、 Stanford CS143、 CMU 15-411; 此外,还有 Robert Nystrom 的 Crafting Interpreters 这样的实践教程. 这些资料并不都停在“能生成目标代码”: CS143 包含类型检查、运行时组织与垃圾回收, 15-411 包含内存管理和运行时组织, Crafting Interpreters 更会带你手写字节码虚拟机、调用栈、闭包与 GC. 编译器课程只是程序语言教育的一部分,不能用它们代表全部本科 PLT 教学.
为什么生产级运行时很难在入门课程里讲透? 我的理解是:一门课的时间有限,而这些内容涉及大量复杂的工程权衡; 另一方面,确实有不少现成的基础设施可以复用. 把自己的语言编译到 LLVM IR,就能利用它的优化与机器代码生成, 但 LLVM 本身不提供垃圾收集器, 更不自动提供完整的语言运行时; 编译到 WebAssembly(WASM)后,可以交给浏览器或其他引擎执行; 编译到 JVM 字节码,则可以利用成熟的 JIT 与 GC. 如果目标是低成本验证语言设计, 我会优先复用现成后端和宿主运行时,而不是从零手写生产级实现.
至于检查系统,也不能指望选定后端就自动得到. 你可以复用现成的类型系统设计、推导算法或实现框架, 但它仍必须和语言语义严丝合缝,能报出人看得懂的错误, 并在表达力和可推导性之间取舍. 所以这一层仍需要自己学、自己走平衡木:类型系统、作用系统,等等. 这也是我最想花时间补齐的一块.
5 给初学者的建议
如果让我给刚进入 PLT 的新人一条建议,那就是: 不要好高骛远,优先保持语言实现的低成本. 有现成的工具就用,不要重复造无意义的轮子. 解析器这一块想手写也行,毕竟复杂度没那么高; 但后端还是先复用 LLVM、Cranelift 等工具,或选择 WASM、JVM 字节码这类目标, 千万别一上来就自己写机器代码后端.
另一条更具体的建议是:把大目标拆成一组最小语言. 当你想要把 A、B、C、D 这些特性组合到一起、却对每一个都不熟悉时, 先分别实现 A、B、C、D 四个最小语言, 各自只保留支撑该特性的最小核心,然后再尝试把它们合体. 这样做有两个好处:一是每个小语言都能在一两天内跑起来, 完成目标带来的满足感可以驱动你继续前进; 二是把它们合体时,你会亲手撞上那些交叉点,这比在纸上空想有效得多.
5.1 入门路线示例
如果让我给自己规划一条路线,目标是设计一门自己用起来很舒服的编程语言, 大概会这样走:
- 从语法开始:不要急着直接上手写解析器, 先用 ANF 的形式把核心语言的语法与求值规则写清楚. ANF 的好处是把求值顺序显式化,让你没法用“反正运行时知道”来糊弄自己.
- 选定 IR:树遍历解释器 → ANF / CPS → 字节码,是最经典的递进路线. 先跑通,再优化,不要一上来就做 SSA.
- 选定类型系统:建议从简单类型 λ 演算起步,先把双向类型检查写顺, 再考虑作用系统;作用系统可以先不碰.
- 复用成熟的基础设施:优先复用后端与宿主运行时, 同时明确列出仍需自己实现或适配的语言语义和运行时支持.
6 运行时的“草台”方案
语言实现还有一种听起来粗糙、但在工业界确有广泛应用的做法: 直接编译到某个成熟语言的源码上,即源到源编译. 它可以复用目标语言的工具链,有时也能复用其运行时,但二者不是同一回事:
- Koka 把程序编译成 C 或 JavaScript;
- TypeScript、CoffeeScript、Elm、PureScript、Reason 与 ReScript 编译到 JavaScript;
- Nim 编译到 C、C++ 或 JavaScript;
- Haxe 编译到多种目标语言;
- Idris 2 通过 Chez Scheme 后端运行;
- Cython 把 Python 的方言编译到 C.
甚至可以更直接一点:生成 Java 源码再交给
javac
javac
. 虽然不够优雅,但能立刻得到 JVM 的 JIT、GC 以及整个生态.
另一条路是把“生成源码”换成“生成中间表示或字节码”: 生成 LLVM IR、QBE 的 IL 或 Cranelift 的 CLIF, 或者生成 WASM、JVM 字节码、.NET CIL、Erlang BEAM、Lua 字节码, 交给相应的后端或执行引擎. MLIR 则是支持多种方言与逐层降级的 IR 框架, 可以帮助组织这些转换,并不是现成的运行时.
这里要分清两种复用:复用后端可以减少优化和机器代码生成工作; 复用 JVM、JavaScript 引擎、Chez Scheme 这样的成熟宿主运行时, 可以进一步减少内存管理和执行引擎工作. LLVM、QBE、Cranelift 本身不是完整的语言运行时, 编译到 C 也不自动获得 GC 或作用处理机制. 无论采用哪条路,都能让自己更专注于语言真正独特的部分, 但仍需实现或适配源语言特有的语义.
毕竟,PLT 的乐趣在于设计语言,而不在于重新发明寄存器分配器.
7 延伸阅读
文中出现的英文术语与缩写,可在 术语对照 中检索:
- 结合力
- binding power
- 部分应用
- partial application
- 部分求值
- partial evaluation
- 多阶段编程
- staging
- 代数作用处理器
- algebraic effect handler
- 定界续延
- delimited continuation
- 一等续延
- first-class continuation
- 高秩多态类型
- higher-rank type
- 高阶类型构造子
- higher-kinded type
- 缩进与换行规则
- offside rule
- 精化类型
- refinement type
- 作用行
- effect row
- 全函数式编程
- total functional programming
- 源到源编译
- source-to-source compilation
进一步阅读的材料:
- matklad. Simple but Powerful Pratt Parsing: 我接触解析的起点.
- Robert Nystrom. Crafting Interpreters: 从树遍历解释器写到字节码虚拟机,很好的入门实践.
- Harold Abelson, Gerald Jay Sussman. Structure and Interpretation of Computer Programs (《计算机程序的构造和解释》):抽象的第一课.
- Benjamin C. Pierce. Types and Programming Languages (《类型和程序设计语言》):类型系统的标准教材.
- Daan Leijen 等. Koka: 把代数作用与 Perceus 引用计数做进真实语言.
- Jeremy Yallop 等. Effects Bibliography: 计算作用与处理器的论文与资料合集.
- Effects Rosetta Stone: 同一种作用在几十种语言或库里的写法对照.
形式化入门:从 BNF 到类型安全
[index]
- 2026-10-10
- Glomzzz
用布尔值与自然数算术语言,从抽象语法、小步操作语义一路证明到类型安全与算法可靠性.
- 2026-10-10
- Glomzzz
在程序语言理论中,形式化是把语言的结构、运行规则与类型规则写成精确定义, 再对这些定义证明性质的方法. 这组文章用一门只有布尔值和自然数的小语言,从零演示这项工作: 怎样定义语法,怎样定义“运行”,怎样定义“类型”, 最后怎样证明“通过类型检查的程序不会受阻”.
不少程序语言爱好者都想过设计一门自己中意的语言. 你可能熟悉代数数据类型、所有权、代数作用,也能在项目里熟练使用它们; 真到动手设计时,脑袋里却常常只剩一堆零散的偏好: “我想要这个特性”“我不喜欢那种写法”. 这不说明你没理解这些概念. 会用一个概念,与决定它在新语言中怎样工作,是两项不同的任务: 设计时还要说明它解决什么问题、在什么条件下可用、与其他特性相遇时会发生什么.
偏好可以是设计的起点,却不能代替对语义及特性之间关系的说明. 形式化不替我们判断什么是好设计, 它让设计中的假设、约束与推论变得明确, 使我们能追问它们是否一致、是否成立、是否达到了预期目标.
研究程序语言时,问题往往很朴素:这段程序会算出什么? 它会不会在运行时崩溃?编译器说它“没有类型错误”,这句话能信吗? 这些问题都能用自然语言问出来; 若要对所有程序给出可核对的保证, 就必须先规定程序的结构、运行规则,以及“类型错误”和“出错”各指什么. 下文用形式化完成这项工作,并用自然语言解释每个定义与证明.
路线依次经过:自然语言与元语言、语法、小步操作语义、规则归纳与确定性、 正规形式与受阻、类型判断、类型安全、检查算法与测试,各篇附带练习.
术语译名以香蕉空间的条目为准, 例如 reduction 译作“规约”,inference rule 译作“推导规则”, normal form 译作“正规形式”,context 译作“语境”,confluence 译作“合流性”; 香蕉空间尚未收录的术语,参考 总结 中“延伸阅读”所列的两篇中文译文, 例如 term 译作“词项”(简称“项”),type soundness 译作“类型健全性”. 算法相对规则的 soundness 称为“可靠性”,并写明比较对象. 全部术语的中英对照及其定义位置见 术语对照 .
自然语言写程序语言规格时的常见歧义,以及对象语言与元语言的分层.
这些约定适用于
形式化入门:从 BNF 到类型安全
的文章与独立条目. 日常交流里,无论是汉语还是英语,自然语言都足够好用. 说话的人和听话的人共享大量背景,含糊的地方可以靠语境补上,补错了再问一句. 写程序语言的规格时,我们仍会用到这些背景,却不能把关键设计留给读者自行补全: 读者可能是其他国家的程序语言研究者,也可能是十年后的自己; 把规格变成实现时,还要交代机器应当执行哪些步骤. 下面几个例子展示这项任务中需要澄清的问题,不是说自然语言一旦含糊就失去了意义.
“咬死了猎人的狗”可以读成“(咬死了猎人)的狗”,指一条狗; 也可以读成“咬死了(猎人的狗)”,指一件事. 两种读法用的字完全相同,差别只在怎样分组. 程序里同样的事随处可见.
人读到这些句子时,常会根据语境和常识选择一种结构,但未必选得一样. 实现解析器时,不能指望程序替我们猜出想要的分组, 必须另行规定文法、优先级或其他消歧办法.
一份规格写道:“
再如“
不完整规格中的类型检查问题
按一套明确的类型规则回答前三个问题; 求值顺序的影响见
求值策略、规约策略与合流性
. 规格的作者心里多半有答案,只是觉得“显然”而没写下来; 然而不同的人眼里“显然”的东西并不一样. C 语言标准用英文写成,几十年来关于某些条款到底允许什么的争论一直没停, 后来还出现了专门把它的含义精确化的研究项目(例如 Cerberus).
“所有测试都没通过”可以是“每个测试都失败了”, 也可以是“并非所有测试都通过了”,后者只要有一个失败就成立. 两种读法的差别在于“所有”和“没”哪个管着哪个. 把量词的作用范围明确写出来: 前者是“对每个 , 都没通过”,后者是“并非(对每个 , 都通过)”. 写出来之后,两句话的结构就不再混淆了. 讲程序语言的性质时,这类句子到处都是. “每个程序都有某个类型”和“存在一个类型,使得每个程序都有这个类型”, 量词顺序一换,意思就完全不同.
下面是 Berry 悖论的一个汉语版本. 考虑这个短语:“不能用少于二十个字来定义的最小正整数”. 先固定一套包含这些字的有限字符表,以字符数计长, 并假定每个有效描述至多定义一个正整数. 少于二十个字的字符串只有有限多个,所以它们至多定义有限多个正整数; 这些短字符串未能定义的正整数中必有最小者,记为 . 若上面这个十八字短语也是同一描述语言中的有效描述, 并且这里的“定义”仍能无条件地适用于包含它自身的全部描述,它又恰好定义了 . 于是 既能又不能用少于二十个字定义,矛盾. 计数本身没有要求先把这个短语排除. 需要检查的是:描述语言与判定“哪个表达式定义哪个数”的语义条件有没有固定, 以及这个语义概念能否在同一层次无限制地涵盖自身. 把描述语言与谈论其语义的元语言分开,是避免这种混用的一种办法, 不是说所有自指都会造成矛盾. 本文把这个教训落实为
对象语言与元语言
的区分: 不把外部描述自动算作内部表达式.练习 1.4 用固定命名表演示这一点. 前面四个例子讲的是说清楚有多难. 还有一个问题更根本:我们想要的结论是关于所有程序的. “这门语言里,通过类型检查的程序都不会在运行时出错”, 这句话谈论的是无穷多个程序. 无穷多个程序没法逐一试验;要得到普遍保证,就需要覆盖它们的论证. 无论用什么语言写,若没有说明分类是否穷尽、每一步依据什么, 读者都很难判断是否漏了情形. “其余情形类似”“显然成立”这些话,写的人常常真心相信, 但这恰恰是错误最容易藏身的地方. 本文采用明确的抽象语法、归纳定义和推导规则, 使结构、适用条件与论证义务能够分别接受检查. 对应前面的问题,我们会作出以下选择: 两个反例能说明为什么这些是具体选择,而不是形式语言自动附送的性质. 文法
形式化让歧义、选择和假设更容易定位; 它本身不保证唯一解析、唯一后继,也不保证所有读者自动理解一致. 展开一句“显然”有时要写好几行,这份工作有用, 是因为它让我们可以逐项核对,而不是因为符号天然比自然语言更高级. 形式化也不是把自然语言赶出去. 下文仍用自然语言说明定义与证明; 出现分歧时,先核对约定、规则及其应用,必要时修改模型或说明. 我们的目标是证明这套规则下的性质,不是为一切语言建立唯一标准.
把思想写成精确符号、使推理能够逐步核对的愿望由来已久. 17 世纪末,Gottfried Wilhelm Leibniz 设想过一种“普遍文字”(characteristica universalis) 以及配套的“推理演算”(calculus ratiocinator): 思想写成符号,推理变成计算,争论的双方只需说一句“我们来算一算”(Calculemus). 两百年后,Gottlob Frege 在 1879 年的 Begriffsschrift(《概念文字》)里真正构造了这样一门形式语言,成为现代逻辑的起点之一. 他在序言里指出,日常语言的推理中常有未曾察觉的前提悄悄混入; 他想要的是一条没有缝隙的推理链,每一步都看得见依据什么.
阅读约定
也采用了这种证明写法: 每个隐含的前提都尽量摆到台面上. Leibniz 的设想没有完全实现. 20 世纪的 Kurt Gödel 和 Alan Turing 证明了, 有些问题原则上不能靠机械计算一劳永逸地裁决. 在程序语言理论中,
一步规约
与
类型与类型判断
用规则精确定义运行和类型,
类型安全
则从这些规则证明良类型程序不受阻, 是这种可核对推理的一个具体例子.
原著位置.下面三组都是意译,不是逐字引文. Philosophische Untersuchungen(《哲学研究》)引自 2009 年 Hacker–Schulte 修订英德对照版 (PDF); Über Gewißheit(《论确定性》)以 德文稿本转录定位, 该页的英文是辅助翻译. 这里借用这些区分作工程方法上的类比,并非 Wittgenstein 对形式语义的评价. 这几节没有禁止逻辑、数学或语言设计;把它们借到这里,是为了校准形式化工作中的三处说法: 模型.
词项的集合
、
一步规约
与
类型与类型判断
规定的布尔值与自然数语言 是为演示目的选的模型,不是任何真实语言的“第一近似”,更不是描述程序语言的唯一秩序. 回答四个问题可以防止它被抬高为必须服从的标准: 接下来要用“树”描述程序的结构,先把相关术语说清楚.
这里约定的树是由节点和连接节点的边组成的有限结构,有唯一的根. 除根以外,每个节点恰有一个父节点; 从根沿父子方向走到任意节点的路径唯一,不会绕回原处. 每个节点可以带一个符号作为标签. 例如表示 的树有三个节点: 根标着 ,它的孩子标着 ,后者的孩子标着 . 前两个是内部节点, 是叶子;以 为根的子树表示 . 这里“子节点”指单个节点,“子树”指从那个节点开始的整块结构. Exercise 1.1. 分组和执行顺序是同一件事吗? “先乘除,后加减”把
可以分别补上“先完整求出左操作数,再求右操作数,最后相加”与相反顺序的规定. 分组解决哪个运算包着哪个运算,执行顺序解决哪件事先发生; 一条优先级约定不能替代后一条规定. Exercise 1.2. 把量词的范围写出来 若把“所有提交的程序都没有接受”理解为“每个提交的程序都遭拒绝”, 那么它为假:甲、乙已经接受. 若理解为“并非所有提交的程序都得到接受”,那么它为真:丙遭拒绝. 第一种说法的否定是“至少有一个提交的程序得到接受”; 第二种说法的否定是“每个提交的程序都得到接受”. 它们的否定也不同,因此原句不能靠读者自行猜范围. 这里约定每次提交最终只有“接受”或“拒绝”两种结果. Exercise 1.3. 补全一份除法规格 一种规定是:两边都必须是非负整数,且除数 必须大于 ; 返回唯一的非负整数 ,满足 . 不满足输入条件时明确报错,不自动把字符串转成整数. 于是
Exercise 1.4. 谈论一个名字,不等于增加一个名字 按命名表, 确实是无法命名的最小正整数, 但这个长短语不在命名表里,所以不是这门语言的名字. 我们能在解释规格的自然语言里描述 ,不意味着那门小语言也能命名它. 如果正式把这个短语加进命名表,必须规定它在新语言中表示哪个数, 原先关于“最小无法命名的数”的结论也须重新检查. 这个练习展示的是:外部描述不会自动成为内部名字. 它不是 Berry 悖论的一般解决方案; 原悖论还涉及能否在同一语言中无限制地使用涵盖自身的可定义性概念, 不能只归结为忘了重新统计. Exercise 1.5. 找出“其余显然”的缺口 取 为“”. 前一百个正整数都满足它, 却不满足. 因此“检查了一百次”只能支持这一百个具体实例,不能独自推出普遍结论. 要证明所有正整数都满足某个性质,还要给出覆盖所有情况的推理方法; “剩下的显然同理”若没有说明相同的前提和推理步骤, 只是在重复待证结论,而不是补完证明. 动手之前,先把
Berry 悖论
留下的教训落实成一条约定.
例如,
词项的集合
、
一步规约
与
类型与类型判断
规定的布尔值与自然数语言是对象语言; 用来写这些定义和证明的自然语言与数学符号属于元语言. 用 Rust 实现这门小语言时,Rust 也充当元语言,见
Rust 也是元语言
. 例如“ 是值”是元语言里的一句话,它在谈论对象语言里的 . 对象语言自己说不出这句话,它里面根本没有“值”这个词. 反过来,元语言里的“所有”“如果……那么”,也不是对象语言的一部分. 在这门小语言里,外部关于项的描述不会自动成为内部表达式, 因此可以避开前面例子中的层次混用. 这不等于只要分层,就排除了所有逻辑问题.
用 Rust 实现
词项的集合
的项 和
一步规约
的运行规则时, Rust 充当
对象语言与元语言
中的元语言: Rust 的
“对象语言/元语言”这对术语与逻辑学家 Alfred Tarski 1933 年关于“真句子”的定义有关: 对象语言 的真,要在另一门元语言 里定义 (见 SEP: Tarski’s Truth Definitions). 按该条目的概括,如果 有足够的资源谈论自己的语义, 他提出的充分性条件(Convention T)很快导向说谎者悖论(“这句话是假的”); Tarski 由此得出结论: 的真定义必须放在一门实质上更强的元语言里. 这个结论针对的是语义封闭与真谓词,不能简化成“自指本身有问题”. 自指在可计算性与证明论里也是常见的正面工具, 后来者还发展出允许语言有限度谈论自身的反射机制等做法. 程序语言理论中的
对象语言与元语言
借用的只是其中的分层组织方式: 所研究的语言和用来研究它的语言分属两个层次, 以便分别说明“语法对象是什么”和“关于它们能证明什么”. 这是
形式化入门
采用的一种设定,不是对所有形式系统的要求.
1.2
为什么不用自然语言
1.2.1
弊端一:一句话有多种结构
1 + 2 * 3
1 + 2 * 3
是 还是 ?
if a then if b then x else y
if a then if b then x else y
里的
else
else
属于哪个
if
if
?
1.2.2
弊端二:没说到的情形
if
if
的条件必须是布尔值,两个分支的类型相同.” 这句话读起来没什么问题,却没有涉及下面的情况:f() + g()
f() + g()
先算两边再相加”. 如果
f
f
和
g
g
都会打印字符,先打印谁?这句话没有规定求值顺序.
1.2.3
弊端三:“所有都不”?“不是所有”?
1.2.4
弊端四:自指问题
1.2.5
弊端五:“显然”没法检查
1.2.6
形式化带来了什么
E ::= E + E | 0
E ::= E + E | 0
已经正式写出,但字符串
0 + 0 + 0
0 + 0 + 0
仍可有两棵解析树; 另一门语言可以明确规定 和 , 得到精确定义却不确定的关系. 本文这门语言是否有唯一后继,要由
确定性
另外证明.
1.2.7
练习:自然语言弊端
Exercises (5)
2 + 3 * 4
2 + 3 * 4
的分组,以及
f() + g()
f() + g()
的调用顺序? 设两个函数都会打印一个字符,请给出两份分组相同、打印顺序不同的完整顺序规定.Solution
2 + 3 * 4
2 + 3 * 4
规定为
2 + (3 * 4)
2 + (3 * 4)
,结果是 , 但没有规定
f() + g()
f() + g()
先调用谁. 设
f
f
打印
F
F
后返回 ,
g
g
打印
G
G
后返回 : 先左后右打印
FG
FG
,先右后左打印
GF
GF
,两者的数值结果都为 .Hint
区分“每一个都被拒绝”和“至少一个没被接受”, 不要只在原句里换一个近义词.Solution
a / b
a / b
返回它们的商”漏掉了哪些情况? 请自行设计一个整数除法操作,完整规定输入范围和错误处理, 并写出三个输入及其预期结果. 答案可以有不同设计,但不能把异常情形留空.Hint
至少说明可接受的输入、非整除时的结果、除数为零的处理; 再给能区分不同规定的例子.Solution
7 / 2
7 / 2
返回 ,
7 / 0
7 / 0
报错,
7 / "2"
7 / "2"
也报错. 第一例排除了“保留小数商”的规定, 后两例分别排除了“零除返回某个普通数”和“字符串自动转换”的规定. 这只是一个可选设计,关键是不能只写“返回商”却把这些决定留给实现者.Hint
先检查规定的命名表里有没有那个短语,再问是否偷偷扩充了语言. 参照
Berry 悖论
.Solution
Hint
构造一个只对前一百个正整数成立的性质, 就能检查有限验证到底证明了什么.Solution
1.3
两个层次的语言
enum Term
enum Term
描述对象语言的项,Rust 的函数描述对象语言的运行. 不要把 Rust 自己的类型(
bool
bool
、
Option
Option
) 和
类型与类型判断
中的对象语言类型(、)混为一谈, 它们分属两层. 实现示例见
Rust 求值器
与
Rust 类型检查器
.
用 BNF 与最小封闭集合定义算术语言的词项,并由最小性导出结构归纳原理.
抽象语法把程序视为语法树,即节点标签表示程序构造的树 (树的术语见
树的基本术语
),而不是一串字符. 从字符串到树的那一步叫解析. 采用这条约定时,假定解析已经完成,而且已经消除了
结构歧义
那样的歧义; 解析器本身不在这条约定的研究范围内. 书写时为了能在一行里写下一棵树,会用括号表示分组: 表示根标着 ,它的唯一孩子标着 ; 这个孩子及其后代构成表示 的子树. 这条约定是第一个“隐含前提”:本文所有的定理都是关于树的. 至于怎样把字符串可靠地变成树,那是另一个话题. 这种只关心树形结构、不关心字符怎么排的语法,叫抽象语法. 文法用产生规则描述允许的语法构造;语法则是关于程序结构的更一般的概念. 本文用文法描述抽象语法树,而不处理字符层面的解析. 常用的文法记号是 BNF,即 Backus–Naur 表示法 (参见维基百科). 它得名于 John Backus 与 Peter Naur,与 ALGOL 60 的语法描述密切相关. 英文名里的 Form 指一种表示形式,不是后文规约理论中的“正规形式”. BNF 用产生式描述各个语法类别,形如 名字出现在自己的右边,就形成了递归.例如 说的是: 可以是 ,也可以是 后面跟着另一个 . 于是 、、 都是 . BNF 本身只是一种记号,它的准确含义要靠下面的“最小集合”来说清楚. 对象语言中的程序称为词项(简称“项”),用元变量 表示. 这门语言只有表达式,没有单独的语句类别;词项的抽象语法用以下 BNF 给出: 竖线读作“或者”. 是 的后继,可以理解为加一; 是前驱,可以理解为减一; 判断 是不是零. 例如 是词项, 它对应的语法树如下: 图中的 是根,有三个孩子; 、、 是只有一个孩子的内部节点; 三个标着 的节点是不同位置上的叶子.
对
词项的集合
中的项, 采用
树的基本术语
的树术语. 根节点的每个孩子所对应的整棵子树,称为它的直接子项.具体地: 沿着“取直接子项”走一步或多步得到的项,称为真子项. 例如 的直接子项只有 , 也是它的真子项,但不是直接子项;整项本身不是自己的真子项. 同一文本可以出现在树的不同位置,谈子项时还要看它所在的位置. 这段 BNF 描述了词项的构造方式;严格的集合含义由以下归纳定义给出.
把词项(简称“项”)视为
抽象语法
中的有限语法树: 常量 、、 是叶子, 、、 是一元构造, 有条件、 分支和 分支三个有序子项. 词项的集合 花体(T) 是满足下面三条封闭条件的最小集合: “最小”的意思是:如果另一个集合 也满足这三条,那么 花体(T) ⊆ S. 也就是说, 花体(T) 只含有限次应用生成规则所能得到的词项,没有其他元素; 这一限制称为最小性子句. 记号 花体(T) 是花体字母 T,可读作
“封闭”说的是:集合里有了 ,就必须也有 等等, 用这几条规则造不出集合外的东西. 为什么还要加“最小”?因为满足封闭条件的集合有很多. 例如允许额外的叶子
取最小集合,就是说: 词项只有用上面三条规则在有限步内构造出来的对象,没有其他元素. 这一限制称为最小性子句;它排除了规则没有生成的额外对象.
词项的集合
有一条存在性前提: 满足那三条封闭条件的集合中真的有最小的. 先固定背景集合 ,包含节点标签取自 、、、、、、 的所有有限有序树(暂不限制每个标签的孩子数量). 本身满足三条封闭条件,所以满足条件的 的子集至少有一个, 取交集不是在对空的一族集合操作. 把所有满足封闭条件的 的子集取交集,记为 : 因此 满足全部封闭条件,而且按交集的定义,它包含在每个满足条件的集合里. 这就是所需的最小集合 花体(T),不是从一堆集合里凭直觉挑出来的. 由此可以得到两件事. 第一,每个项都是一棵有限的树:叶子是 、、, 内部节点是 、、(各有一个孩子) 或 (有三个孩子). 第二,语法只规定形状,不保证项满足类型规则. 和 都是合法的项; 它们是否良类型,要由后面的类型规则判断. 操作语义则单独规定项能怎样规约, 不良类型的项也在它的讨论范围内,甚至可能正常求值. 在 Rust 里,这个集合可以表示为枚举.
从树的角度看,
最小性不只排除额外元素,还给出结构归纳法. 要证明“所有词项都满足性质 ”,不必逐一检查无穷多个词项: 只需验证常量的基准情况,再验证各个构造子的归纳情况, 也就是证明当直接子项满足 时,由它们构成的词项也满足 .
“归纳”这个词在不同领域里意思不一样,先分清楚. 数学归纳法的历史很长. 古希腊的 Euclid 证明素数有无穷多个时,已经有了它的影子; 16 世纪的 Francesco Maurolico、17 世纪的 Blaise Pascal 在讨论二项式系数时比较明确地用了它; “数学归纳法”这个名字是 19 世纪 Augustus De Morgan 起的. 19 世纪末,Richard Dedekind 由自然数的最小性推导出归纳原理, Giuseppe Peano 则把归纳列入自然数公理.
结构归纳原理
把这个想法从自然数推广到由规则搭起来的有限树.
词项的集合
的有限项 与
一步规约
的有限推导,采用的是归纳定义: 由这些有限前提的规则生成最小集合,每个对象都有有限的构造或推导. 余归纳则可用相应单调算子的最大不动点刻画对象或行为,并据此证明性质. 它可以描述无限展开,例如无穷数据流或无限运行,但不意味着其中只有无限对象: 带空构造子的余归纳列表就可以同时包含有限和无限列表. 共递归侧重怎样按观察结构逐步产生这样的对象; 要定义可用的无限数据,还须保证每次索取有限的可观察部分都能在有限计算后得到, 这称为生产性. 非结构递归不自动就是共递归,也不自动具有生产性. 列表与受保护共递归的例子见 A Tutorial on [Co-]Inductive Types in Coq §7. 先想想“最小”为什么能推出归纳. 设 是所有满足 的项组成的集合. 如果 能“跟着规则搭上去”,意思就是 也满足那三条封闭条件, 用这三条规则同样搭不出 之外的对象. 而 花体(T) 是这类集合里最小的,即每个这类集合的子集. 因此 花体(T) ⊂ S, 花体(T) 的每个项都在 里,都满足 . 如果没有“最小”, 花体(T) 里可能混进
设 是关于
词项的集合
中有限项的性质.如果下面三条都成立: 那么对所有项 , 成立. 在这里,结构归纳不是额外请来的对象语言公理: 在元语言的集合论背景下,它由“最小”这两个字推出. 这不是说一切数学基础都不需要公理, 而是说定义了这个最小集合以后,不必再另加一条关于它的归纳公理.
归纳假设是在归纳步骤中,对归纳原理许可的更小对象暂时假定的性质. 它是用来证明“如果这些更小对象满足 ,那么当前对象也满足 ”的前提, 不是把“所有对象都满足 ”或当前待证结论预先当真. 在
结构归纳原理
的第 2 条中,归纳假设是 ; 第 3 条中是 、、. 这些对象恰好是
直接子项与真子项
列出的直接子项. 常量没有子项,所以基准情况没有归纳假设,必须直接证明. 为什么这种暂时假定合法?我们首先证明的是条件命题; 每个实际词项都由有限次构造得到,从已经验证的叶子出发, 逐层应用这个条件命题,就能把性质传到根. 假设只沿着更小的结构使用,不会绕回当前待证结论.
取
词项的集合
中的有限项, 树的术语见
树的基本术语
, 归纳方法采用
结构归纳原理
. 取 为“ 至少含有一个叶子”.常量本身就是叶子,基准情况成立. 证明 时,
归纳假设
给出 中有一个叶子; 加上 根以后,那个叶子仍然存在. 证明 时,任取某个孩子中的叶子即可. 对于 ,先验证 ,再推出 , 最后推出整项的性质,没有一步用到尚未证明的结论. 反过来,试图证明错误命题 :“ 不含 ”, 然后在 的情形里说“假定 ,所以它不含 ”, 就是循环论证:用待证结论本身支持待证结论. 它至多证明了 , 没有证明归纳步骤要求的 . 实际取 ,前者 为真,后者 为假,反例立刻出现. 循环也可以藏在两步里: “为了证明父项满足 ,先用父项满足 来证明子项满足 ,再由子项推出父项”. 两句话合起来仍然没有独立的起点.
“只能对直接子项使用”是
结构归纳原理
的直接表述, 不是一切归纳法的限制. 若改用强归纳,先证明某个自然数度量严格下降, 就可以对度量更小的任意对象使用
归纳假设
;对真子项的归纳也可以成立. 一般的要求叫良基性:不存在无限地向更小对象下降的链.
直接子项与真子项
的直接子项关系 在
词项的集合
的有限树上是良基的, 但“规约后的项”并不因此自动是直接子项. 例如按
一步规约
, 一次计算变成 ,后者不是前者的直接子项. 要在证明中对规约结果使用
归纳假设
,必须另证合适的度量下降,或选择相应的归纳原理. 若把归纳假设用在不属当前归纳原理许可范围的对象上,证明就缺了一步; 若这个缺口依赖当前结论来填补,就构成循环论证. 再看一棵具体语法树上的归纳方向. 要证 对整棵树成立,只需在叶子处直接验证(第 1 条), 并在每个内部节点处假定以各个孩子为根的子项都满足 , 再推出以当前节点为根的项满足 (第 2、3 条). 这里 是项的性质,不是单个节点标签的性质. 箭头表示“由孩子所在的子树推出父节点所在的子树”,信息自下而上流动:
“先把对象定义成满足某些规则的最小集合,再沿着这些规则归纳”, 这个方法在许多理论里反复出现: 这些理论研究的对象虽然各不相同,所用的核心方法是同一个.
写“对 结构归纳”时,意思是应用
结构归纳原理
: 按项的形状逐个情形讨论,每个情形里可以对
直接子项与真子项
所列的直接子项使用
归纳假设
. 采用
规则归纳法
作规则归纳时, 更小对象则是规则前提对应的子推导,不是任意看起来有关的项. 先用两个函数练手,它们分别计算一棵语法树有多少个节点、有多深:
对
词项的集合
的有限语法树, 大小 数节点, 深度 数从根到最远叶子的路径上的边. 两个函数按
直接子项与真子项
的直接子项递归定义: 深度数的是从根到最远叶子的路径上的边数,不是节点数.完整定义为: 例如 有三个节点、两条边,所以大小是 ,深度是 . 的大小是 ,深度也是 : 大小把三个分支都算进去,深度只取最长的那条路径. 这里还有一条隐含前提:按项的形状逐个情形写等式,真的定义出了函数吗? 答案是肯定的,因为每个项恰好属于一种形状 (
抽象语法
已经保证没有歧义), 而右边只用到直接子项的函数值,子项又更小,一路往下总会落到常量上. 这种定义方式称为结构递归,它和结构归纳是同一枚硬币的两面: 结构归纳沿着项的构造过程证明性质,结构递归则沿着同样的结构定义函数. 熟悉 Haskell 的读者会认出, 这正是许多基于归纳类型(也称代数数据类型)和模式匹配的递归函数所采用的方式. Haskell 也允许非结构递归,但不能把它们一概称为共递归; 利用惰性求值逐步产生无限列表是共递归的常见例子, 还须检查它能否持续给出可观察部分(
什么是归纳
). 接下来这条引理检查“大小”和“深度”两个定义是否协调: 最长路径用到的节点不会超过整棵树的节点数. 它也给递归的资源估计一个上界,例如遍历语法树时,递归栈深度不超过节点总数. 没有这个证明,这只是直觉; 如果误把 的深度写成三个分支深度之和加一,就不再是在数最长路径了. 例如三个分支各有深度 时,这种错误写法给出 ,但实际最长路径只有 条边. 要证明递归终止,还需另查每次调用的参数是否严格变小,不能只引用一个数值上界.
形式化证明大致就是这个样子:按定义的情形逐个核对,每个情形里只用定义和
归纳假设
.
Aristotle 区分过两种无穷: 潜无穷是可以无限进行下去的过程,比如数数总能再数下一个; 实无穷则是已经完成的无穷整体. 词项的集合 花体(T) 可以从两个角度看: 按
词项的集合
的集合定义,它是现成的无穷集合(实无穷); 按“用规则在有限步内搭出来”的生成方式,每个词项都是有限过程的产物.
结构归纳原理
的关键在于: 它让我们对无穷集合下结论,却只需检查有限多条规则. 这也是数学基础里构造主义认可归纳定义的原因:每个对象都有有限的构造历史. 潜无穷体现在“总能构造出更大的有限项”这一点上: 单个项由有限步骤构成,这一事实本身并不说明潜无穷;说明它的是项的构造过程没有上界. Exercise 2.1. 把项还原成树 三个直接子项依次是 、、 ,大小都为 ,深度都为 . 所以整项大小为 ,深度为 . 三个标着 的节点都没有孩子,都是叶子; 根 和其余六个一元节点都是内部节点. 是整项的真子项,但不是直接子项. 不能因为三个叶子的标签相同,就把它们合并成同一个位置. Exercise 2.2. 语法合法,不等于满足类型规则 是项:先由第一条生成 ,再由第二条包上 . 也是项: 三个常量都由第一条生成,再用第三条组合. 单独的
Exercise 2.3. 封闭与最小各负责什么? S = 花体(T) ∪ {null} 不封闭:,但 . 它既不是原语言的项,也不是单独补进去的
要得到含
Exercise 2.4. 证明边数比节点数少一 Exercise 2.5. 两种不同的错误“归纳证明” 第一段是循环论证:它假定的是当前待证的 , 不是结构归纳许可的 .它只证明“结论蕴涵自身”. 第二段使用子项上的假设本身合法,但推理错误: 只能给出 ,不能给出 . 取 ,子项大小为 ,包上一层后为 . 所以 是假命题,不是把措辞修好就能证明的. 也是大小为 的反例.
2.1
语法树
2.2
BNF
2.3
词项
script T
script T
; 它表示词项集合,与后文表示类型的元变量 不同.null
null
, 并且把所有包含这个新叶子的 、 等树也一起加进来, 得到的更大集合仍然满足封闭条件. 但
null
null
不是本文的项,因为三条生成条件没有给出它. 注意,只加
null
null
而不加 等树,反而会破坏封闭性.
enum
enum
的值只能由这几个构造子有限次地组合出来,“最小”由语言本身保证:// 对象语言的项(定义“词项的集合”)
#[derive(Clone, Debug, PartialEq, Eq, Hash)]
pub enum Term {
True, False,
If(Box<Term>, Box<Term>, Box<Term>), // if t1 then t2 else t3
Zero,
Succ(Box<Term>), Pred(Box<Term>), IsZero(Box<Term>),
}// 对象语言的项(定义“词项的集合”)
#[derive(Clone, Debug, PartialEq, Eq, Hash)]
pub enum Term {
True, False,
If(Box<Term>, Box<Term>, Box<Term>), // if t1 then t2 else t3
Zero,
Succ(Box<Term>), Pred(Box<Term>), IsZero(Box<Term>),
}Box<Term>
Box<Term>
是指向堆上
Term
Term
的指针,并且独占它指向的那块内存. 为什么不直接写
Succ(Term)
Succ(Term)
?因为 Rust 要在编译时知道每个类型占多少字节. 如果
Succ
Succ
里直接装一个
Term
Term
,那个
Term
Term
里又可能装一个
Term
Term
…… 大小就成了无穷大,编译器会报错
recursive type has infinite size
recursive type has infinite size
. 换成
Box
Box
以后,
Succ
Succ
里装的只是一个固定大小的指针,真正的子树放在堆上.Box
Box
正好对应语法树里的一条边: 父节点通过它“拥有”自己的子树,子树不和别的节点共享. 也正因为独占,
Box
Box
不能按位复制; 复制一个项要用
.clone()
.clone()
把整棵子树深拷贝一遍,后面的代码里会看到这一点.
2.4
结构归纳
null
null
这样的例外: 它不是上面三条规则搭出来的,规则对这种例外什么也没说, 对它成不成立也就无从谈起. “最小”保证了 花体(T) 里只有规则搭出来的东西, 所以“对每条规则检查一遍”就等于“对每个项检查一遍”. 下面把这段论证写成定理.
Inductive
Inductive
、
inductive
inductive
、
data
data
是这一思想的直接实现,Rust 的
enum
enum
则是它的工程化形式.
2.5
练习:语法
Exercises (5)
Hint
根是 ;三个直接子项要按条件、 分支、 分支的顺序列出. 大小数节点,深度数最长路径上的边.Solution
if
├── iszero
│   └── pred
│       └── 0
├── succ
│   └── succ
│       └── 0
└── pred
    └── succ
        └── 0
if
├── iszero
│ └── pred
│ └── 0
├── succ
│ └── succ
│ └── 0
└── pred
└── succ
└── 0pred
pred
、字面记号
1
1
. 不要用“它运行时会出错”作为不属于项集合的理由.Solution
pred
pred
不是项,因为这个构造必须带一个子项. 字面记号
1
1
也不在这套抽象语法里; 后面会用 表示自然数一,但不能未经约定就把
1
1
当成已有的构造. 前两个项都满足语法的生成条件; 这既不保证它们有类型,也不保证求值能到达值. 是否有类型、怎样规约,要分别对照后面各自的规则, 不能混成一个“有没有意义”的判断.Hint
集合里一旦有
null
null
,封闭条件对 会提出什么要求?Solution
null
null
.null
null
的封闭集合, 必须同时加入所有由原构造子和这个额外叶子在有限步内搭出的树, 包括 、 等. 这个集合满足原来的封闭条件,却严格大于 花体(T). “封闭”要求构造后不能跑到集合外,“最小”则排除规则没有生成的额外东西.Hint
常量有零条边;一元构造增加一条边; 根连向三个孩子,增加三条边.Hint
第一段用了哪个对象上的假设? 第二段虽然取了子项,还要检查不等式是否真的能传给父项.Solution
定义算术语言的值与一步规约关系,区分基本规约规则与结构规则. 上一节定义词项的语法:它由哪些构造子、按什么结构组成. 这一节定义词项的语义,也就是在给定模型中的意义. 程序语言语义学研究怎样赋予程序精确的数学意义. 本文采用操作语义:通过执行状态及其执行关系描述程序行为. 具体采用的是小步操作语义,每次转移描述一步执行. 在这门语言中,执行状态就是词项,不需要另加存储或环境.
不完整的规格
里“先算哪边”的问题,将由转移规则规定; 规则是否保证下一步唯一,还须另行证明.
哲学里研究“究竟什么是存在的、存在者有哪些基本形式与范畴”的分支称为 本体论(此处仅作帮助记忆的类比,并非对本体论的哲学论证). 这里说的“语法类似本体论”,只指对象语言的语法对象:
词项的集合
列出了这门算术语言里有哪些词项, 而“最小”保证除此之外没有别的对象. 但只有“是什么”还不够. 可以借古希腊哲学中关于存在与变化的两种思路作对照: Parmenides 的论述强调存在者的不生不灭与不变; Heraclitus 则常由后人读作强调流变的哲学家. “人不能两次踏进同一条河流”的说法, 见 Plato 《克拉底鲁篇》402a 中 Socrates 对 Heraclitus 的转述; 它不能不加说明地当作原著残篇的逐字引文,对流变思想的解释也有分歧 (见 SEP: Heraclitus). 这里只作思想对照,不把它写成两人直接交锋、随后调和的历史过程. Aristotle 讨论变化时区分潜能与现实, 可以借它提示“有某种能力”与“这种能力的实现”之间的区别; 这一概括不代替他的完整变化理论 (参见 SEP: Aristotle’s Metaphysics §12). 这个区分在操作语义里有一个直观的对应. 按
一步规约
, 词项 作为语法对象就是它自己,不会改变; 但它在转移关系下可以规约到 .
值与数值
所划出的值, 则可以比作已经没有规约余地的项:它不能再转移到别的项 (
值不可规约
). 语法管“有哪些项”,语义管“项怎样一步步转移”. 这个对应只用来帮助记忆;具体结论仍由规则、反例与证明承担. 先划出“已经算完”的项.
在
词项的集合
的词项中,用以下 BNF 文法划出值. 读作“定义为”, 读作“或者”; nv 是数值的元变量,不是对象语言的关键字. 形如 的词项称为值,形如 nv 的词项称为数值. 和
词项的集合
一样, 这两行 BNF 定义的是满足相应封闭条件的最小集合. 数值就是 、、……,分别代表 . 几个例子: 规约是依据规则把词项改写为另一词项, 例如把 改写为 ,再改写为 . 一次改写称为一步规约,连续零次或有限多次改写称为多步规约. 规约不天然保证词项更小或更接近终点;本文的终止性要由大小严格下降另行证明. 在本模型中, 同时是词项之间的转移关系: 描述从状态 到状态 的一次转移. 程序执行就是依次作这样的转移.
数学上, 是二元关系: 它是由若干 对组成的集合, 是 的简写. 我们用推导规则定义它.一条规则形如 读作:如果横线上的前提全都成立,那么横线下的结论成立. 没有前提的规则称为公理;它是推导规则的特例,不需要先证明其他判断就能使用. 横线右边可以标上规则的名字,方便引用.
在
一步规约
与
类型与类型判断
的规则里, 等字母是元变量: 它们属于元语言,可以代换为
词项的集合
中的任意词项, 并不是对象语言中可执行的变量. 只能代换为值, nv 只能代换为数值 (
值与数值
), 则只能代换为类型. 同一条规则中同一个元变量的所有出现必须使用相同的代换. 一条推导规则因此表示许多具体实例,而不是只适用于这些字母的陈述. 元变量的取值范围也是规则的一部分. 例如 nv 只能表示数值,不能用任意词项代换. 文献还常把额外限制显式写成附加条件,放在横线旁或前提中; 它们必须满足,才能应用规则,不能靠读者自行补全.
以
词项的集合
的词项作为执行状态, nv 只取
值与数值
中的数值. 一步规约关系 ,即此模型的小步转移关系, 是对下列十条推导规则封闭的最小二元关系. 成立,当且仅当存在以这个判断为结论的有限推导. 每条横线之上的判断是前提,横线之下的是结论;前提全部成立,结论才成立. 没有前提的规则称为公理,可以直接使用. 同一条规则中相同的元变量必须代换成同一个项,见
元变量
. 这里的“最小”和
词项的集合
里的“最小”含义相同: 成立,当且仅当能用这十条规则的实例搭出一棵以它为根的有限树. 这棵树称为推导树,也称推导. 推导规则是通用的规则模式, 推导则是把规则实例组合起来、证明具体判断的有限结构. 规则没有提到的情形,例如 该规约到哪里,就是没有定义. “没有定义”在这里有精确的含义: 十条规则里没有一条的结论能匹配 (E-Succ 的结论形状对得上,但它的前提要求 能规约,而没有规则能做到), 所以不存在任何 使 . 遇到没有定义的情形该怎么办? 形式化的回答是:不要假装它有定义,而是把它当作明确的状态来对待. 常见做法有三种:
以
词项的集合
的语法 和
一步规约
的十条求值规则为基础, 可以另行加入错误项 ,并规定错误传播. 以下讨论的是这门扩展语言,不把新增规则当作未扩展语言的规则. 只写 还不完整: 还要处理 、、非布尔条件,以及嵌套位置里的错误. 记 为 或 , nv 为
值与数值
中的数值. 可以补上这些错误规则,其中 分别取 、、: 原同余规则继续向正在求值的子项推进. 于是 先规约到 , 再规约到 ; 先变成 ,再向外传播成 . 本身不再规约,应识别为异常终点,而非原来定义的普通值. 未选中的分支仍不会求值,例如 得到 , 不能不分位置地把整项都传播成错误. Kotlin 可以显式写出这种异常控制流:
必须区分三个对象: 是对象语言里的错误词项,
仅仅补上运行时错误规则,不会自动得到这样的子类型系统. 若把显式异常加入
类型与类型判断
的定型系统, 也必须写明异常如何定型,并相应重述
进展
与
保型
; 不能直接套用未扩展语言的证明就声称“良类型程序永不抛异常”.
类型安全
采用的则是未扩展语言:不加入错误项,让类型规则排除受阻.
JavaScript 没有把
图中每条边同时列出
传递性要求: 与 相等、 与 相等,就能推出 与 相等. 这个三角图正好展示
但
JavaScript 隐式转换与相等三角图
展示了
隐式转换确实能少写一些代码,例如让输入得到的字符串
这会变成实际的算法问题. 假如自己写去重函数:按输入顺序扫描,只要新值与某个已保留的值满足
更容易推理的设计,是把“验证输入”“转换表示”和“比较”分开: 在需要数字的边界先检查哪些输入可接受,再显式转成数字, 最后使用不做隐式转换的比较. 仅仅把
对新语言,这意味着不要只问“这个常见例子能不能少写一次转换”, 还要问“加了这条便利规则以后,原有的推理性质是否还在,和其他规则组合会怎样”. 这不等于所有隐式转换都不可取; 需要判断的是转换保留了什么信息,以及它是否会掩盖应当暴露的错误. 对已经部署的语言,直接改掉旧规则又可能破坏依赖它的代码, 因而常常需要显式提供更清楚的操作,并用工具约束旧操作的使用. 少写一次转换的局部便利,可能变成整个语言长期承担的理解与兼容成本. 所以“补上约定结果”不是“随便猜一个结果”: 必须完整规定转换顺序,并检查这些约定保留了哪些性质、放弃了哪些性质. 这也是
显式错误规则与 Kotlin 的底类型
中显式报错方案与隐式转换方案的真正取舍: 有时拒绝一次操作,比给它一个出乎意料却合法的结果更有帮助. 无论选哪种,关键是写下来. C 语言标准里的未定义行为是典型的反面教材: 标准明确说某些情形没有定义,却没有要求实现报错, 于是编译器可以假设它们永远不会发生,并据此做出让程序员意外的优化.
使用
一步规约
的规则, 推导树的每条横线都是一条规则的实例: 横线上方的子推导满足前提,下方给出结论. 以下三层合起来只证明整项的一步规约,不是三步运行. 从下往上读:要说明最下面那一步成立,用 E-Pred,它要求里面的 能一步规约; 这又用 E-If,它要求条件 能一步规约; 最后 E-IsZeroZero 是公理,无条件成立. 这十条规则分成两类:一类规定基本运算怎样执行,另一类规定基本步骤可发生在哪些位置. 规约规则(也称计算规则或收缩规则)直接规定基本运算的结果: E-IfTrue、E-IfFalse、E-PredZero、E-PredSucc、E-IsZeroZero、E-IsZeroSucc. 能直接匹配这类规则的词项,称为可规约表达式,简称可规约项. 这里的六条基本规约规则没有关于 的前提; 这个特征不是所有语言的规约规则都必须满足的.例如: 结构规则(也称同余规则)把子项的规约提升到指定的求值位置: E-If 允许规约条件,E-Succ、E-Pred、E-IsZero 允许规约各自的参数.
3.2
值
nv ⩴ 0 | succ nv
3.3
推导规则怎么读
1 + "a"
1 + "a"
抛出
TypeError
TypeError
是类似的运行时处理; Kotlin 的例子以及它与底类型的关系见
显式错误规则与 Kotlin 的底类型
.true + 1 === 2
true + 1 === 2
就是这种做法. 它给这类运算规定了普通结果,但不代表所有程序都会正常返回; 隐式转换也可能掩盖本想发现的错误, 见
JavaScript 隐式转换与相等三角图
.
fun succ(x: Any): Int = when (x) {
    is Int -> x + 1
    else -> throw IllegalArgumentException("succ expects an Int")
}

fun fail(message: String): Nothing =
    throw IllegalArgumentException(message)

fun requireNat(n: Int): Int =
    if (n >= 0) n else fail("negative number")

// succ(true) 会抛出异常;requireNat(-1) 也会抛出异常.
// 这里借用 Kotlin 的 Int 演示错误处理,不把机器整数当作无界自然数.
fun succ(x: Any): Int = when (x) {
is Int -> x + 1
else -> throw IllegalArgumentException("succ expects an Int")
}
fun fail(message: String): Nothing =
throw IllegalArgumentException(message)
fun requireNat(n: Int): Int =
if (n >= 0) n else fail("negative number")
// succ(true) 会抛出异常;requireNat(-1) 也会抛出异常.
// 这里借用 Kotlin 的 Int 演示错误处理,不把机器整数当作无界自然数.requireNat
requireNat
的
else
else
分支为什么能放在需要
Int
Int
的位置?
fail(...)
fail(...)
的类型是
Nothing
Nothing
,表示它不会正常返回一个值. Kotlin 的 类型系统规格 把
Nothing
Nothing
定义成底类型,通常写作 . 它是任何类型的子类型,即 对任意 成立. 这里 表示子类型关系,即 是 的子类型; 相关类型规则允许 类型的表达式用在要求 类型的位置. 因此不返回的失败分支可以和返回
Int
Int
的成功分支放在同一个
if
if
里.IllegalArgumentException
IllegalArgumentException
是 Kotlin 的异常对象, 是描述表达式不会正常产出值的类型. 异常对象本身不是
Nothing
Nothing
;
Nothing
Nothing
没有正常的值,也不是
null
null
(
Nothing?
Nothing?
是另一回事). 抛异常的表达式可以具有底类型,永远循环的表达式也可以不返回, 所以不能把“错误”与 当作同义词.
true + 1
true + 1
留作未定义,而是明确规定转换后得到
2
2
. 同样,宽松相等
==
==
规定了按两边种类进行转换的规则; 严格相等
===
===
则不做这种转换,不同种类的操作数直接判为不相等. 把两种比较放在一起看:true + 1; // 2:true 转换为 1
[] == 0; // true
[] === 0; // false
0 == "0"; // true
0 === "0"; // false
[] == "0"; // false
[] === "0"; // falsetrue + 1; // 2:true 转换为 1
[] == 0; // true
[] === 0; // false
0 == "0"; // true
0 === "0"; // false
[] == "0"; // false
[] === "0"; // false==
==
和
===
===
的结果,不是规约箭头. 绿色实线表示
==
==
为真,红色虚线表示
==
==
为假; 第二行单独记录
===
===
,这里三条边都为假.[] == 0
[] == 0
会先把空数组转换成空字符串
""
""
,再因另一边是数字而把
""
""
转成
0
0
;
0 == "0"
0 == "0"
会把字符串
"0"
"0"
转成数字
0
0
,所以这两条边都为真. 但
[] == "0"
[] == "0"
把数组转成
""
""
后,两边已经都是字符串,只比较
""
""
与
"0"
"0"
,结果为假. 具体转换规则见 MDN 的
==
==
文档.==
==
不满足传递性,不能像数学等号那样用于替换或推理.
===
===
不会做上述转换:数组、数字、字符串种类不同,所以这三个比较都为假. 它回答的是另一个问题,而不是“同一套转换做得更严格”.===
===
也不等于完整的数学等价关系. 自反性要求每个值都与自身相等,而
NaN === NaN
NaN === NaN
为
false
false
. 对对象,
===
===
比较的是是否为同一个对象,不是内容是否相同:
const a = []; a === a
const a = []; a === a
为
true
true
,
[] === []
[] === []
却为
false
false
, 因为后者创建了两个不同的数组. 严格相等的完整规则见 MDN 的
===
===
文档.
[] == 0
[] == 0
与
0 == "0"
0 == "0"
为真、
[] == "0"
[] == "0"
为假的三角关系. 它让人觉得“地狱”,不是因为结果随机:每一条比较都能按规格算出来. 难受之处在于,名字叫“相等”,却不能沿用相等最基本的推理. 我们原本希望“ 等于 、 等于 ”能让第三次比较省下来, 现在却必须重新跑一遍转换规则. 定义得精确与设计得容易理解是两件事; 形式化能让问题无处藏身,却不会自动把糟糕的约定变成好约定."0"
"0"
直接和数字
0
0
比较. 但
==
==
并不是先把每个值各自转换成某个统一表示,再比较这个表示: 一个值怎样参与比较,还取决于另一边是什么种类. 三角图里,同一个
[]
[]
遇到数字时走到
0
0
,遇到字符串时却停在
""
""
. 这份便利的代价是:读者不能只看一个值就知道比较会怎样进行, 必须同时记住另一边以及两者触发的规则.==
==
,就把新值丢掉. 输入
[[], 0, "0"]
[[], 0, "0"]
时,先保留
[]
[]
,丢掉与它“相等”的
0
0
, 再保留与它“不相等”的
"0"
"0"
,结果留下两个值; 换成
[0, [], "0"]
[0, [], "0"]
,后两个值都与
0
0
“相等”,结果只留一个值. 普通去重也可能因顺序不同保留不同的代表, 但若依据的真是等价关系,不应连分成几类都随顺序改变. 这里说的是这个自定义的
==
==
算法,不是 JavaScript 的
Set
Set
;
Set
Set
使用的是另一套比较规则.==
==
换成
Number(a) === Number(b)
Number(a) === Number(b)
也不够, 因为
Number("")
Number("")
与
Number([])
Number([])
都是
0
0
; 如果空输入或数组本来就是错误,仍应拒绝它们,而不是转换后假装正常. 相等操作也要讲清楚是在比较对象身份、结构内容,还是领域中的某个键, 并且检查算法需要的自反性、对称性与传递性. 不同任务可以有不同规则,但不能只靠“相等”这个名字暗示它们全都成立.
3.4
规约规则与结构规则
- 因为 (E-PredZero), 所以 (E-Succ);
- 因为 (E-IsZeroZero),所以 (E-If).
这里的“同余”强调规约与特定构造相容,不表示一步规约是同余等价关系: 有方向,而且只对规则许可的位置封闭. 把许可位置另写成带一个空位的求值语境,再规定怎样在空位处执行基本规约, 就得到语境语义(也称规约语义)的写法. 参见 Hutton 译文第 6 节,以及 Harper §1.3.1.
这套小步语义中,每棵一步推导都由零次或多次结构规则与顶端的一次基本规约规则组成. 从结论向上读,结构规则定位正在求值的子项,基本规约规则执行其中的运算. 一棵推导 就是两次结构规则(E-Pred、E-If) 加一次基本规约(E-IsZeroZero).
上图中
pred
pred
和
if
if
节点是结构规则经过的路径,
iszero 0
iszero 0
是基本规约发生的位置; 虚线连接的分支不参与这一步.
规则的细节里藏着设计决定,读的时候要留意:
- E-If 只允许在条件里规约,没有规则允许在分支里规约. 因此先求条件,再选择分支,不会提前计算未选中的分支. 下文 求值策略、规约策略与合流性 会把这样的顺序规定称为求值策略,并与一般的规约策略区分.
- 基本规约规则要求正在检查的操作数已经是合适的值,但不要求未选中的分支是值. 例如 E-PredSucc 的左边是 pred (succ nv), 只有 里面已经是数值时才能用;否则只能先用结构规则把里面算完. 这保证了“先算里面,再算外面”的顺序, 下面的 为什么 E-PredSucc 要求 nv 会说明为什么这一点很重要.
这里与晚期 Ludwig Wittgenstein 对语言使用的关注作有限的类比. Philosophische Untersuchungen(《哲学研究》)§43(以下均为意译)说: 对“意义”一词的一大类用法(但不是全部),可以这样解释: 词的意义就是它在语言中的使用;它还补充说,名字的意义有时是靠指出其承担者来解释的. 针对程序构造的计算行为,
一步规约
选择用操作语义明确规定允许的规约步骤: 它不靠自然语言的直觉解释说明 “是什么”,而是规定它在计算里怎样使用. 这个模型让具体行为与规则之间的关系可以逐条核对; 它的价值应通过反例、性质证明和实现来说明. 需要留意两处边界. 第一,Wittgenstein 讨论的“使用”还涉及学习、应用和纠错的共同实践, 不能直接压缩成一份明列的形式规则; 《哲学研究》§198–202 恰恰处理规则与行动的关系: §198 说,解释本身“悬在半空”,单靠解释不能确定意义,规则与行动的联系在于已有的用法与习惯; §199、§202 说,遵循规则是一种习惯、制度或实践,自以为在遵循并不等于遵循; §201 把“任何行动都能解释得与规则一致”当作需要消解的困惑,而不是结论. 所以,写下来的规则要得到遵循,仍依赖这样的实践 (原文见 《哲学研究》英德对照版). 第二,逻辑学里的推理主义 (Gerhard Gentzen、Dag Prawitz、 Michael Dummett、Robert Brandom 一脉) 主张逻辑联结词的意义由引入与消去的推导规则给出. Gentzen 本人在 Investigations into Logical Deduction(《逻辑推演研究》,Szabo 编英译本) 第二部分 §5.13 里说,引入规则好比相应符号的“定义”,消去规则不过是这些定义的后承(意译). 这些讨论的是证明与推理;它与程序如何执行有联系,但“都使用规则”不足以说明两者是同一个问题. 因此,这里不把操作语义说成上述哲学立场的“工程版本”, 只借它们提示一个问题:把某个语法构造的用法写清楚,会带来哪些可核对的性质.
用规则归纳法证明一步规约的确定性,并证明 Rust 求值函数与规约规则一致. 是对规则封闭的最小关系,因此具有规则归纳法. 它与
结构归纳原理
的依据相同: 每个可推导的 都来自有限次规则应用; 只要待证性质在无前提的规则上成立,并能由每条规则的前提传到结论, 就对所有可推导的转移成立.
设 是关于一对词项的性质. 若对
一步规约
的每条规则实例, 假定前提中的各个转移都满足 后,能够证明结论中的转移也满足 , 则 对所有可推导的 成立. 无前提的规则是基准情况,须直接验证其结论满足 ; 有前提的规则是归纳情况,可对前提的子推导使用归纳假设. 这就是规则归纳法,也可理解为对有限推导树作结构归纳. 归纳对象是可推导的转移,不只是其中左端词项的语法. 直观地说,规则归纳就是对推导树的结构或高度归纳, 请对照
一棵推导
理解. 公理对应没有前提的叶子,是基准情况, 没有
归纳假设
可用; E-If 这类带前提的规则对应归纳情况, 可以对前提的子推导使用归纳假设,再证明当前结论的性质. 为什么不总是对项归纳? 因为这里已知的是一棵 的推导,要跟踪的性质同时涉及左右两项; 按最后用的规则拆解,就能得到前提里的子推导以及左右两边怎样拼成结论. 确定性和保型都会用到它. 若只试了几条规约链,或只处理无前提的基本规约规则而漏掉 E-If 等结构规则, 就不能覆盖嵌套项:例如内层规约保持类型,并不替你证明外层 拼回去以后也保持类型. 规则归纳正是把这个“拼回去”的步骤逐条核实. 在证明确定性之前,要先确认“已经算完的值”确实不能再走一步. 这既给求值器提供了可靠的停止条件,也用来排除基本规约规则和结构规则同时适用. 若另加 这样的规则, 虽仍是语法上指定的值, 按“不能再走”判断停止的求值器却会永远循环; 后面的确定性证明也不能再用“值不能规约”排除重叠.
为什么要证明下面的确定性? 因为我们准备实现每次只返回单个后继项的函数
对
一步规约
定义的关系 , 若 且 ,则 . 证明采用分类讨论(也称分情形讨论):穷尽所有可能情形并逐一论证. 分类必须确实覆盖每一种可能;这里穷尽的是有限种规则,不是逐一枚举无穷多个词项. 之所以能保证分类穷尽,是因为 是最小关系, 任何推导的最后一步只能是十条规则之一. 下面覆盖这十种情形,对称或重复的论证合并说明; 每个情形里,再按结论左边的形状排除不匹配的规则,检查第二个推导剩下的候选规则. 具体地,对 作规则归纳(
规则归纳法
), 要证的性质是“对任意 , 蕴涵 ”. “任意 ”必须写进性质里,否则
归纳假设
只能用于某个固定的 ,在 E-If 情形就不够用. 每个情形里,再看 的推导最后一步可能是哪条规则: 它的结论左边必须和 形状相同. 这个证明没什么巧思,功夫全花在排除情形上. 这正是形式化的用处,下面的附注给出具体例子.
一步规约
的 E-PredSucc 规则左边是 pred (succ nv), 只允许 里面是
值与数值
中的数值. 表面上也可以放宽成任意项: 毕竟“先加一再减一”就是原来的数,何必等里面算完? 问题在于,放宽以后同一个项会有两种规约方式. 取 : 两个结果不一样,
确定性
就不再成立. 在证明里,这表现为 E-PredSucc 那个情形写不下去: 要排除第二个推导是 E-Pred,需要“ 不能规约”,而 不一定是值,这一点推不出来. 这个例子里两条路最后都会到达 ,所以这个项的最终结果没有变,但一步关系已不再确定. 仅凭这个例子还不能断言整个扩展语言的所有最终结果都不变,那需要另外的证明. 我们仍可以写一个按某种策略选后继的函数, 但它实现的是受策略限制后的关系,不能再声称它枚举了原关系的全部一步结果 (见
求值策略、规约策略与合流性
). 这个决定是由证明推动的:证明写不下去时,要么调整设计,要么调整所要保证的性质, 不能把缺口当作已经证明.
用测试对照证明
所述的确定性测试也抓到了放宽后的反例.
确定性
表明:对每个词项 ,至多有一个一步后继 . 因此 对应偏函数:有后继时返回唯一后继,没有后继时无定义. 用 Rust 实现时,可以把返回类型写成
规约策略规定:当词项的多个位置都能改写时,选择哪个位置、哪条规则作为下一步. 求值策略则规定语言怎样求得程序的结果, 包括先算哪些子表达式、函数参数何时计算、是否计算函数体内部,以及算到什么形式就停止. 文献有时混用这两个词;这里用前者强调“选规约路线”,用后者强调运行时的整体约定. 能直接应用一条基本规约规则(也称计算规则或收缩规则)的子表达式, 称为可规约表达式,简称可规约项. 先看只含精确整数运算、没有副作用的例子. 括号固定语法树;允许在任意子表达式里计算一次加、减、乘或整除时,下面的项至少有两条路线: 如果规定“先完整求出左操作数,再求右操作数,最后计算根”, 求值器就选蓝色实线路线,右边虚线路线不属于这个受限制的一步关系. 这里的策略只限制何时用基本规约规则,不改变这套整数运算规则给出的结果. 运算符优先级解决的是怎么解析字符串,不是这里的先后顺序: 语法树已经由括号固定,两条路线没有重新分组,也没有把浮点加法当成可任意结合的运算. 真实语言里,JavaScript、Python 的普通函数调用会先求实参再执行函数体, 通常称为按值调用;JavaScript 还规定实参从左到右求值. Haskell 使用按需调用:需要某个参数的值时才计算,并共享这次计算的结果. 例如 Haskell 的
有副作用时,连最后的普通数值也可能不同. 设 JavaScript 中
多条路线能否重新汇合,是另一个性质,叫合流性. 这里临时把一般规约关系也记成 ,把零步或有限多步记成 (正式定义见
多步规约
): 若 且 ,总存在 ,使 且 , 就称这个关系合流. 上图展示了可汇合的分叉;只画出这一个例子并没有证明整套关系合流. 合流不要求“下一步唯一”:、 可以不同,只要求它们之后还可以到达同一项. 若某个项能到达两个正规形式 (不能继续规约的项,正式定义见
正规形式与受阻
), 合流保证这两个正规形式相同,因为正规形式已经无法再走向第三个不同的项. 若没有合流保证,就不能从“各条路最后都停了”推出结果唯一: 假想规则同时允许某个 规约到常量 和 ,而两个常量都不能再规约, 它们就永远无法汇合. 选择策略可以挑出其中一个,却不消除原关系里的这种分歧. 但合流不保证终止,也不保证任意策略都能找到已经存在的正规形式. λ 演算是只用变量、函数抽象和函数应用描述计算的形式系统. 表示参数为 、函数体为 的函数; 表示把 应用到 . 变量出现的位置若受某个 的参数绑定,称为绑定出现;否则称为自由出现. 例如 中参数 只规定绑定范围,函数体里的 是自由变量. 一般的 β 规约允许在任何子项中使用 其中 表示把 中自由出现的 替换成 , 必要时先把绑定变量改名,以免意外捕获 的自由变量. β 规约也允许在函数体内部规约,不要求 已是值,所以通常有多条路线. Church–Rosser 定理表明,一般 β 规约是合流的 (把只差绑定变量名字的项视为同一个项). 这里引用这一经典结果而不展开其证明; 它说明一般 β 规约虽然有多条路线,仍不会从同一个项得到两个不同的 β-正规形式. 参见 Church–Rosser 定理. 例如 可以先规约外层, 得到 ,也可以先规约实参,得到 ; 两边都再规约到 . 但令 , 它一步规约回自己,永远不会算完. 若先算外层就得到正规形式 , 若坚持先算实参就会在 上无限规约. 一般 β 规约仍然合流,却不能靠合流保证这条策略终止. 因而要分清三件事:确定性管每一步是否唯一, 合流性管不同路线能否重新汇合,终止性管是否可能一直算下去. 引入确定的规约策略可以把多路线关系限制成可由单后继函数实现的关系, 但它不自动保持所有可达结果; 要声称“最终结果不变”或“总能找到正规形式”,还需要相应的证明.
一步规约
的十条求值规则已经规定了策略,
确定性
证明的正是这套规则的确定性. 先把前面的
每个分支旁边标了它实现的规则. 结构规则对应的分支都用到了
在
Rust 求值器
例如,读取字符串的首字符,并把 ASCII 小写字母转成大写: 对照
一步规约
中的同余规则: E-Succ 说“若 ,则 ”.
确定性说明关系至多有一个后继,但还没有说明
取
Rust 求值器
两个方向各有分工. “仅当”方向(
“若”方向要用
值不可规约
排除“别的分支抢先匹配”的情形, 这与
确定性
证明里的排除论证同源. 反过来看也成立:
(仅当:
(若: 蕴涵
这条定理接上的是“规则”与“Rust 函数”之间那道缝, 与
算法可靠性
和
算法完备性
对类型检查器做的事相呼应. 它是对这段 Rust 代码的纸面论证,没有机器检查; 对代码里没有写出的细节(例如
Rust 求值器
确定性
保证的是后继唯一,不是适用的规则唯一. 例如另加一条名字不同、结论也为 的规则, 两条规则就同时适用,却没有产生不同的后继. 对于原来的十条规则,互斥性要靠具体排除论证: 条件是 或 时,由
值不可规约
,E-If 的前提不成立; 的参数是 或 succ nv 时,参数也是值, E-Pred 的前提不成立,两个计算形状又彼此不同; 的情形相同. 参数能规约时,反过来排除这些计算形状. 这些正是确定性证明中用到的逐形状分析,但不只是确定性结论本身. 因此,代码先列计算分支、再列递归分支,不会把另一条适用的规则藏起来. 分支内部是否返回了正确的项,还要由
求值器与一步规约一致
的双向对应保证. 若放宽 E-PredSucc 的数值限制,排除论证就失效,单后继函数只能另外选择策略, 见
为什么 E-PredSucc 要求 nv
.
step
step
. 它要完整实现一步规约关系,就必须证明关系不会给同一输入两个不同后继; 否则
match
match
的分支顺序可能偷偷选掉另一条合法路线.
为什么 E-PredSucc 要求 nv
会给出放宽一条规则就失去这一保证的具体反例; 多路线不必然是语言设计错误,但必须说明是否用策略限制它 (
求值策略、规约策略与合流性
).
4.5
从关系到函数
Option<Term>
Option<Term>
,以
None
None
显式表示没有后继. 这样能把数学上的偏函数扩充为词项到可选结果的全函数,前提是它对每个输入都终止; 仅有这个返回类型并不保证终止. 下面的
step
step
及
is_nv
is_nv
都沿直接子项递归,克隆也只处理有限子树, 所以在
算术语言形式化的未展开前提
的资源与基础操作假设下会正常返回. 若一步关系有多个后继,函数仍然可以选择其中一个,但必须写明选择的策略; 否则它只实现了关系的一部分,却误说成实现了整个关系.
const
const
满足
const x y = x
const x y = x
,
error
error
用于产生错误;
const 1 (error "boom")
const 1 (error "boom")
返回
1
1
,因为第二个参数没有用到; JavaScript 的
((x, y) => x)(1, (() => { throw new Error("boom"); })())
((x, y) => x)(1, (() => { throw new Error("boom"); })())
会先计算第二个实参而抛错. 两门语言都有明确的策略,但选的是不同路线和停止条件.let n = 0
let n = 0
,
f = () => ++n
f = () => ++n
,
g = () => n * 10
g = () => n * 10
.
f() + g()
f() + g()
按从左到右求值给出
11
11
; 若另一门语言规定先算右边,先得到
g() = 0
g() = 0
,再得到
f() = 1
f() = 1
,结果就是
1
1
. 所以“随便选一条路线”不是无害的实现细节;
不完整的规格
里没写明的顺序必须在规格里补上.Term
Term
定义重新贴在这里,方便对照:#[derive(Clone, Debug, PartialEq, Eq, Hash)]
pub enum Term {
True, False,
If(Box<Term>, Box<Term>, Box<Term>), // if t1 then t2 else t3
Zero,
Succ(Box<Term>), Pred(Box<Term>), IsZero(Box<Term>),
}#[derive(Clone, Debug, PartialEq, Eq, Hash)]
pub enum Term {
True, False,
If(Box<Term>, Box<Term>, Box<Term>), // if t1 then t2 else t3
Zero,
Succ(Box<Term>), Pred(Box<Term>), IsZero(Box<Term>),
}Term
Term
没有派生
Copy
Copy
.
Copy
Copy
的意思是“按位复制一份就是合法的副本”,而
Box
Box
独占堆上的子树; 按位复制会得到两个指向同一块内存、都以为自己负责释放它的指针, 所以 Rust 不允许含
Box
Box
的类型实现
Copy
Copy
. 下面代码里的
(**a).clone()
(**a).clone()
、
a.clone()
a.clone()
是在显式地深拷贝子树:
a
a
的类型是
&Box<Term>
&Box<Term>
,
*a
*a
是
Box<Term>
Box<Term>
,
**a
**a
是
Term
Term
./// nv ::= 0 | succ nv
pub fn is_nv(t: &Term) -> bool {
match t { Term::Zero => true, Term::Succ(t) => is_nv(t), _ => false }
}
/// v ::= true | false | nv
pub fn is_value(t: &Term) -> bool {
matches!(t, Term::True | Term::False) || is_nv(t)
}
/// t ⟶ t'.返回 None 表示不存在 t':t 是值,或者受阻了.
pub fn step(t: &Term) -> Option<Term> {
use Term::*;
match t {
If(c, a, b) => match &**c {
True => Some((**a).clone()), // E-IfTrue
False => Some((**b).clone()), // E-IfFalse
c => Some(If(Box::new(step(c)?), a.clone(), b.clone())), // E-If
},
Succ(t1) => Some(Succ(Box::new(step(t1)?))), // E-Succ
Pred(t1) => match &**t1 {
Zero => Some(Zero), // E-PredZero
Succ(n) if is_nv(n) => Some((**n).clone()), // E-PredSucc
t1 => Some(Pred(Box::new(step(t1)?))), // E-Pred
},
IsZero(t1) => match &**t1 {
Zero => Some(True), // E-IsZeroZero
Succ(n) if is_nv(n) => Some(False), // E-IsZeroSucc
t1 => Some(IsZero(Box::new(step(t1)?))), // E-IsZero
},
True | False | Zero => None, // 值不可规约
}
}/// nv ::= 0 | succ nv
pub fn is_nv(t: &Term) -> bool {
match t { Term::Zero => true, Term::Succ(t) => is_nv(t), _ => false }
}
/// v ::= true | false | nv
pub fn is_value(t: &Term) -> bool {
matches!(t, Term::True | Term::False) || is_nv(t)
}
/// t ⟶ t'.返回 None 表示不存在 t':t 是值,或者受阻了.
pub fn step(t: &Term) -> Option<Term> {
use Term::*;
match t {
If(c, a, b) => match &**c {
True => Some((**a).clone()), // E-IfTrue
False => Some((**b).clone()), // E-IfFalse
c => Some(If(Box::new(step(c)?), a.clone(), b.clone())), // E-If
},
Succ(t1) => Some(Succ(Box::new(step(t1)?))), // E-Succ
Pred(t1) => match &**t1 {
Zero => Some(Zero), // E-PredZero
Succ(n) if is_nv(n) => Some((**n).clone()), // E-PredSucc
t1 => Some(Pred(Box::new(step(t1)?))), // E-Pred
},
IsZero(t1) => match &**t1 {
Zero => Some(True), // E-IsZeroZero
Succ(n) if is_nv(n) => Some(False), // E-IsZeroSucc
t1 => Some(IsZero(Box::new(step(t1)?))), // E-IsZero
},
True | False | Zero => None, // 值不可规约
}
}?
?
,它的作用见下面的附注.
?
?
运算符
[rust-question-mark-operator]
Option<T>
Option<T>
是 Rust 里表示“可能有值、可能没有”的类型, 只有两种取值:
Some(x)
Some(x)
和
None
None
. 在返回
Option
Option
的函数里,表达式
e?
e?
的意思是:e
e
是
Some(x)
Some(x)
,整个
e?
e?
的值就是
x
x
,继续往下执行;e
e
是
None
None
,函数立刻返回
None
None
,后面的代码不再执行.step
step
中,
Succ(t1)
Succ(t1)
匹配后继项,
step(t1)
step(t1)
返回
Option<Term>
Option<Term>
,表示子项是否存在一步后继. 这个分支可以写成两种等价形式:// 用 ?
Succ(t1) => Some(Succ(Box::new(step(t1)?))),
// 不用 ?,展开写
Succ(t1) => match step(t1) {
Some(t1_) => Some(Succ(Box::new(t1_))),
None => return None,
},// 用 ?
Succ(t1) => Some(Succ(Box::new(step(t1)?))),
// 不用 ?,展开写
Succ(t1) => match step(t1) {
Some(t1_) => Some(Succ(Box::new(t1_))),
None => return None,
},fn first_char_upper(s: &str) -> Option<char> {
let c = s.chars().next()?; // 空字符串时这里直接返回 None
Some(c.to_ascii_uppercase())
}
assert_eq!(first_char_upper("rust"), Some('R'));
assert_eq!(first_char_upper(""), None);fn first_char_upper(s: &str) -> Option<char> {
let c = s.chars().next()?; // 空字符串时这里直接返回 None
Some(c.to_ascii_uppercase())
}
assert_eq!(first_char_upper("rust"), Some('R'));
assert_eq!(first_char_upper(""), None);step(t1)?
step(t1)?
先去找 ,找到了就拿来搭结论; 找不到(前提不成立),结论就推不出来,整个函数返回
None
None
. 这正好对应“子项不能规约,整个项也不能沿这条规则规约”.
类型检查器
type_of
type_of
里的
type_of(t1)?
type_of(t1)?
也是同样的意思: 按照
类型与类型判断
的规则, 子项没有类型,就无法满足相应构造的定型前提,检查器返回
None
None
.step
step
返回的就是这个后继. 下面的定理把两者接上: 函数返回的每个后继都能由规则推出,规则允许的每个后继函数也都能返回.
step
step
, 规约关系采用
一步规约
, 实现论证采用
算术语言形式化的未展开前提
的资源与基础操作假设. 对任意项 与 :
step(t) = Some(u)
step(t) = Some(u)
当且仅当 .step
step
蕴涵规则)说明函数返回的每个后继都能由规则推出, 函数不会凭空造出规则不允许的一步. “若”方向(规则蕴涵
step
step
)说明规则允许的每个后继函数都能返回, 函数没有漏掉任何合法路线.step
step
是函数,所以只要这条定理成立, 若 且 ,则
step(t)
step(t)
同时等于
Some(u)
Some(u)
与
Some(u')
Some(u')
,于是 . 也就是说,对这十条规则,这条定理蕴涵确定性,是确定性的另一条证明路线. 若把 E-PredSucc 放宽成任意项,“若”方向会在这一情形失败, 见
为什么 E-PredSucc 要求 nv
.step(t) = Some(u)
step(t) = Some(u)
蕴涵 ) 对 结构归纳,按
step
step
实际走到的分支分情形.step
step
返回
None
None
,前提不成立.step(t1) = Some(t1')
step(t1) = Some(t1')
,. 由
归纳假设
得 ,用 E-If 即得.step(t1) = Some(t1')
step(t1) = Some(t1')
,.由
归纳假设
与 E-Succ 即得.is_nv
is_nv
为真),返回 nv,这是 E-PredSucc; 其余情形
step(t1) = Some(t1')
step(t1) = Some(t1')
,由
归纳假设
与 E-Pred 即得.step(t) = Some(u)
step(t) = Some(u)
) 对 作规则归纳(
规则归纳法
), 按最后一步的规则分情形.step
step
的前两个分支直接返回 、.step
step
走第三个分支. 由
归纳假设
得
step(t1) = Some(t1')
step(t1) = Some(t1')
,于是返回 .step
step
的前两个分支返回规则的结论; E-PredSucc 的条件
is_nv
is_nv
正是规则对 nv 的限制.step
step
走第三个分支. 由
归纳假设
得
step(t1) = Some(t1')
step(t1) = Some(t1')
.clone
clone
的行为)仍然依赖对 Rust 语义的默认理解. 配套工程
code/plt-arith
code/plt-arith
里的
determinism
determinism
测试把
step
step
与逐条照抄规则的枚举器在有限样本上对照, 这是对定理的经验检验,不是它的证明.
step
step
用模式匹配实现
一步规约
的规则.
match
match
按书写顺序尝试分支; 要说明这种优先级没有漏掉合法后继,不能只说“函数每次返回一个结果”.
区分作为合法终点的值与作为运行时错误的受阻项,并定义多步规约关系.
采用
一步规约
的关系 . 若不存在词项 使 ,称 是正规形式. 按
值与数值
判断, 不是值的正规形式称为受阻词项. 正规形式与受阻都相对于给定的转移规则定义; “正规形式”不表示正常结果,也不保证每个词项都能到达唯一正规形式. 正规形式是相对于给定规约关系没有后继的词项, 好比 化简到 后不能再算. 这里的定义只问“还能不能规约”, 不保证结果合法、存在或唯一,也与 BNF 中的 Form 无关. 在本文的关系下,正规形式分成两种: 非值(受阻的项):不能再规约,但也不是值, 计算停在了规则无法继续处理的地方.例如:
英文 stuck 字面是“卡住”,Types and Programming Languages 的一些中文译本也这样译.
正规形式与受阻
采用“受阻”这个译名,理由有两点. 第一,“卡住”在日常语言里也指程序“卡死、无响应”,容易让人联想到无限循环; 而这里的受阻不是无限循环:项已经没有后继,却也不是值,停在了不合法的终点. 在包含并发或阻塞操作的语言中,哪些状态算受阻,还取决于转移规则和许可终态的定义; 死锁也可能表现为非终态且无后继,不能笼统地说它与 stuck 无关. 第二,“受阻”点出了停下来的原因:计算想往前推进,却遇到没有定义的情形而无法继续. 例如按
一步规约
的规则, 既不是值,也没有可用的规约步骤. 英文原名可对照
术语对照
检索. 本文用受阻建模一类运行时错误: 例如词项要求把布尔值加一,但没有转移规则处理这一操作. 受阻不是所有真实语言错误的统称; 显式抛异常、无限循环与这里的“非值且无后继”仍须区分. 下一节的类型系统会在不按求值规则运行程序的前提下拒绝一些项; 我们要证明,类型系统接受的项不会走到受阻状态. 检查器拒绝某项可以报为编译期错误,但遭拒绝不意味着实际求值一定受阻. 这套规则的保守性见
类型系统是保守的
. 一步规约只描述“一次改写”. 程序真正运行时要连续改写很多次,所以需要把若干步串起来.
以
一步规约
的关系 为基础, 读作“ 多步规约到 ”, 表示从 出发经过零步或有限多步一步规约到达 . 精确地说,它是对下面两条规则封闭的最小关系: M-Refl 给出零步规约,即自反性;M-Step 把一步接到有限多步之前. 由于取的是最小关系, 成立当且仅当存在一条有限链 (). 上角的星号表示重复零次或多次,与 Kleene 星号的惯例一致; 称为 的自反传递闭包.
采用
一步规约
的十条规则, 表示
多步规约
的零步或有限多步规约; 终点是否为值按
值与数值
判断. 每行右边列出了这一步推导用到的规则,从外层的结构规则写到最里层的基本规约规则. 三步之后到达值 ,所以 由
确定性
,每一步都别无选择,所以这条链是唯一的. 也包括中间每一站:这个项也多步规约到第二行、第三行的项,以及它自己(零步).
按
一步规约
的规则, 取 . 是否为值采用
值与数值
, 是否受阻采用
正规形式与受阻
. 第一步. 的最外层是 . 结论左边形如 的规则只有 E-Succ, 它要求里面的 能规约. 这个 的条件是 ,E-IfTrue 适用,得到 .于是推导是: 第二步.现在的项是 . 仍然只有 E-Succ 可能适用,它要求 对某个 成立. 但 是值,由
值不可规约
不能规约, 于是 E-Succ 的前提搭不上,没有任何规则可用: 是正规形式. 它又不是值( 后面必须是数值),所以它受阻了. 第一步完全合法,问题出在第二步. 所以某个词项“现在还能规约”并不说明它“永远不会出错”. 规约链会不会永远走下去?对这门小语言,不会.
采用
大小与深度
的大小函数与
一步规约
的十条规则. 若 ,则 . 因此,从 出发的任何规约链至多有 步,不存在无限规约链. 对 作规则归纳(
规则归纳法
), 按最后一步的规则分情形. 对步数:设 . 每一步大小至少减 ,所以 . 大小至少为 ,故 . 这条引理说明规约链有限. 结合
求值器与一步规约一致
, 在
算术语言形式化的未展开前提
的资源与基础操作假设下, 反复调用
Rust 求值器
多步规约仍属于小步语义: 它把执行步骤串起来,右端 可以是任意中间状态,不必是值. 大步操作语义(也称自然语义)则通常直接定义词项与最终值之间的求值关系, 常记为 . 不能只因 描述了多次改写,就把它当作大步语义; 两种定义是否给出相同的求值结果,需要针对具体规则证明. 也不要把“实现成函数”直接等同于指称语义. 指称语义通过值化函数把词项映射到语义域, 并要求复合词项的意义由子项的意义组合而成,即满足组合性. 操作语义同样可以实现成函数; 区别在于它定义的是执行关系,还是词项在语义域中的意义. Exercise 3.1. 值、正规形式与受阻别混在一起 因此“不是值”不等于“受阻”,“有坏的子项”也不等于“现在受阻”. Exercise 3.2. 一条链与第一步的推导树 四步所用的规则依次是 E-Pred + E-If + E-IsZero + E-PredZero, E-Pred + E-If + E-IsZeroZero,E-Pred + E-IfTrue,E-PredSucc. 第一步的完整推导是: 最后 是值,没有后继. 多步规约还包括链的中间各站与起点自身,不只是最终结果. Exercise 3.3. 扩展:函数选一条路,不等于关系只有一条路 把 E-PredSucc 改成允许任意 的 后, 取 . 直接消去外层得到 ; 先用同余规则进入内部,得到 . 两个后继不同,所以一步关系不确定. 第一条路线再用 E-IsZeroZero 到 , 第二条路线再用放宽的 E-PredSucc 到 ; 因此这个分叉可以汇合.但一个可汇合的例子不证明整套扩展关系合流. Rust 函数即使按分支优先级选出唯一返回值,也没有消除关系的另一条合法路线. 要么实现“所有后继”的接口, 要么明确说这个单后继函数实现的是选定策略限制后的关系. 注意扩展规则下 能规约, 不能照搬它在原语言中受阻的判断. Exercise 3.4. 换一个相等三角形
使用
相等关系的“地狱”给语言设计什么教训
的自定义
Exercise 3.5. 扩展:错误只沿实际求值的位置传播 对 , 原语言与错误扩展都用 E-IfTrue 直接得到 ,不计算 分支. 原语言中的 没有后继,是受阻的正规形式. 错误扩展先在内部用 E-OpBool,并由 E-Pred 提升到整项,得到 ; 再用 E-OpWrong 到 .它是明确的异常终点,不是普通数值. 是错误项,
5.3
多步规约
step
step
会在有限次返回后得到
None
None
. 测试实现时不能预先假定它恰好实现了规则,仍应检查每个返回后继是否更小. 这条引理不说明链的终点是值还是受阻的项;那个问题由类型安全回答.
5.4
练习:求值
Exercises (5)
Solution
Hint
第一步不是消去最外层 , 而是经由三条同余规则进入条件中的 .Solution
step
step
用
match
match
只返回其中一个,能否据此声称扩展关系仍确定?Solution
""
""
、
0
0
、
"0"
"0"
两两计算
==
==
与
===
===
的结果,画出另一个相等三角形. 再按“新值与任何已保留值满足
==
==
就丢弃”的算法, 分别去重
["", 0, "0"]
["", 0, "0"]
与
[0, "", "0"]
[0, "", "0"]
. 它们为什么连保留下来的数量都可能不同?Hint
比较空字符串
""
""
、数字
0
0
和字符串
"0"
"0"
. 同类字符串的
==
==
不会再把两边都转成数字.Solution
"" == 0
"" == 0
和
0 == "0"
0 == "0"
为
true
true
,
"" == "0"
"" == "0"
为
false
false
; 三组
===
===
都为
false
false
. 前两次把字符串转为数字,第三次只比较两个不同的字符串.==
==
去重算法, 输入
["", 0, "0"]
["", 0, "0"]
留下
["", "0"]
["", "0"]
,输入
[0, "", "0"]
[0, "", "0"]
只留下
[0]
[0]
. 规则明确仍可能失去算法所依赖的传递性; 改用
===
===
后这三种输入彼此不同,在这个例子中不会合并, 但仍要留意对象身份和
NaN
NaN
的特殊处理.Solution
IllegalArgumentException
IllegalArgumentException
是异常对象, 是底类型. Kotlin 的抛异常表达式可以具有
Nothing
Nothing
类型, 不意味着异常对象是底类型的值,也不意味着未选中的异常分支必须先执行.
定义算术语言的类型判断与良类型词项,利用语法导向性质证明类型反演与类型唯一性. 类型系统是在词项的抽象语法上定义的一组规则; 它说明哪些词项与类型之间的关系可以成立. 先区分三个概念:类型关系是词项与类型之间的关系, 类型判断是形如 的陈述, 类型规则则规定怎样证明这样的判断.
设 是
词项的集合
中的词项. 类型的语法为 ,分别表示布尔类型与自然数类型. 词项与类型是不同的语法类别,类型系统定义的是它们之间的关系. 类型关系由下列七条类型规则归纳定义:它是对这些规则封闭的最小关系. 类型判断 读作“可以由类型规则推出词项 具有类型 ”; 判断成立,当且仅当存在以它为结论的有限推导. 推导符号 在这里标记可推导性,不是词项的构造子,也不是求值符号. 含变量的语言通常写作 , 读作“在语境 中,词项 具有类型 ”. 也称类型环境,记录作用域内变量的类型假设; 把这些假设与待证陈述分开.
词项的集合
的算术语言没有变量,所以采用空语境,并省略 . 为简洁起见,讨论这套规则时, 是 的简写. 横线上的判断是前提,横线下的是结论; 没有前提的规则称为公理,仍是推导规则的特例. 、 等符号按
元变量
代换: 只能取类型, 只能取词项; T-If 两个分支里的 必须代换成同一个类型.
对
类型与类型判断
的类型关系, 若存在某个类型 ,使得 有一棵由这些规则搭成的有限推导, 则称词项 是良类型的;否则称 是不良类型的. 这个定义有三处值得拆开来看: 规则的读法与
一步规约
相同: 横线上是前提,横线下是结论,、 是元变量(
元变量
). 这里还要注意类型与词项是不同的语法类别: 只能代换为 或 , 则代换为词项. T-If 的两个分支可以同为任一种类型,但同一次规则应用中的 必须一致; 这不是说两个分支可以分别任取一个类型. 类型规则同样是归纳定义,因此也可以对类型推导使用规则归纳法, 原理与
规则归纳法
相同. 这种横线上列前提、横线下列结论的写法来自形式逻辑,与自然演绎的记号相近; 它首先描述可推导性,不是直接规定检查器的执行顺序.
使用
类型与类型判断
的七条类型规则, 良类型与不良类型的含义见
良类型
. 良类型的例子. 要说明 ,从结论往上搭推导: 每个前提都搭上了,合起来就是完整的推导: 不良类型的例子. 要说明 没有类型, 得证明对任何 都搭不出 的推导. 可以直接穷举七条规则: 唯一可能作为最后一步的 T-Succ 无法满足前提, 因此不存在合法的推导树, 是不良类型的.
采用
类型与类型判断
的七条规则,
不完整的规格
中的三个类型检查问题可以得到明确回答:
为
类型与类型判断
中的类型判断寻找推导时, 从要证的结论出发,选一条结论形状对得上的规则,再去搭它的每个前提. 这七条规则是语法导向的,每个子项的候选规则由语法形状确定, 见
反演
. 但 T-If 有三个前提,推导搜索仍是一棵树,不是单条路径. 按指定的检查顺序,可以定位首先失败的前提;这条诊断由三样信息确定: 以 为例, 按条件、 分支、 分支的顺序检查. 最外层选 T-If;第一个前提 由 T-True 搭上; 第二个前提要求 ,T-Zero 给出 ; 第三个前提于是要求 ,但 T-IsZero 的结论类型是 . 断点因此是:T-If 的第三个前提,子项 ,期望 ,实际 . 编译器的报错信息
Rust 检查器
按
一步规约
的 E-IfTrue, 一步就得到值 ,不会受阻; 但
类型与类型判断
无法给它赋予类型, 因为 T-If 要求两个分支类型相同. 这套类型规则相对于“求值不会受阻”是保守的:它拒绝了一些能够正常求值的项.
类型安全
只保证良类型的项不受阻,没有保证逆方向. 这里的保守性不能仅由“不运行程序”推出.
词项的集合
、
一步规约
规定的算术语言中,每一步都使大小严格下降 (
规约使大小严格下降
), 而
求值器与一步规约一致
保证
选择当前的语法导向类型系统,是另一种取舍: 它按子项的类型组合出整项的类型,不必先求出条件的真假; 两个分支具有同一类型,也让分支选择后容易证明保型. 它对原类型关系是否可靠、完备,与它是否接受所有能正常求值的项,是两个不同的问题. 含有一般递归的语言会遇到另外的判定限制, 不能拿那些限制代替对这门有限、终止语言的分析. 先看这组规则的结论. 每条规则的结论都形如“某个项 : 某个类型”, 结论左边的项有一个最外层构造子(、、 等),这就是它的形状. 把七条规则按结论左边的形状列出来: 这张表的第三列全是 :本文的每种项形状恰好对应一条候选定型规则. 这组规则是语法导向的: 可以依据项的语法形状确定应尝试哪条规则,不必猜测最后一步. 一般来说,语法导向不要求每个项都有规则可选,更不保证规则的前提都成立; 没有匹配规则或前提搭不上,都可能导致拒绝. Harper 在 Type Systems for Programming Languages §1.2 中的表述是“至多一条规则”,不要误解为“必须恰好只有一条”. 作为对照,如果再加一条规则 (“自然数可以当布尔值用”), 它的结论左边是任意项 ,不按项的形状限制. 仅看 的语法形状,既不能排除 T-Zero,也不能排除这条转换规则, 最后一步不再由形状唯一决定. 具体要推出 时,最后用的是转换规则,它的前提 再由 T-Zero 给出. 语法导向带来很方便的推理方式: 知道了 成立,就能断定推导的最后一步用的是哪条规则, 于是那条规则的前提也都成立. 例如,知道 成立,查表可知最后一步必然是 T-Succ, 于是立刻得到 且 ,不用知道推导的其余细节.
良类型与不良类型
里的两个例子也是这样做的: 每一步都只有一条规则可选.
以下结论只针对
类型与类型判断
的七条类型规则; 表示能由这些规则搭出有限推导,、 分别是布尔类型与自然数类型. 反演把“某个判断存在推导”拆成任何合法推导都必须满足的信息. 它不是把推导规则的蕴涵方向直接倒过来, 而是利用规则定义的最小关系,穷尽结论可能来自的规则. 保型证明例如从 pred (succ nv) : T 开始, 必须先知道 、 succ nv : Nat,再继续取出 nv : Nat, 才能证明删去外层构造以后类型还在. 没有反演,就不能凭外观擅自断言子项有哪些类型; 增加子类型规则时这个推理尤其需要重证,下面的附注会给出原因.
反演
中直接确定最后一条规则的证明, 依赖
类型与类型判断
的语法导向性质: 每种项形状只对应一条候选规则. 如果将来加一条不看项形状的规则 (例如子类型里常见的“若 且 ,则 ”), 那么 的最后一步就可能是这条新规则, “最后一步必然是 T-Succ”的推理就断了. 到那时反演需要重新陈述、重新证明. 这不是说非语法导向系统不能证明反演引理,而是不能直接沿用这份逐形状的证明. 语法导向并不单凭“每种形状只有一条规则”就让输出类型自动唯一: T-If 的 还要从分支中确定. 下面的定理补上这个保证,说明
Exercise 4.1. 从结论搭起一棵类型推导 每个叶子都是 T-Zero,两个分支具有同一个类型 . 定型过程中没有执行任何 规约; 条件最后会变成什么,不是搭这棵推导的前提. Exercise 4.2. 证明没有类型,而不是只说“检查失败” 这三种分析排除了所有可能的最后规则,所以是不存在推导的论证. 第一个项却可以规约到 :实际没有执行坏分支. 这再次说明“不良类型”并不等于“这次运行必定出错”. Exercise 4.3. 反演不需要看见整棵推导 T-If 给出 、、. T-Pred 给出 以及 ; T-Succ 再给出 .代回得到 . 因而一定有 、、、. 这只提取已有推导必须满足的前提, 并没有假定 或 已经求值,也不需要猜原推导的其他细节.
6.1
类型判断
expected Nat, found Bool
expected Nat, found Bool
,内容就是这三样信息. 若先用 分支确定 ,也可以报告 分支的 “期望 ,实际 ”; 首先报告哪一处,取决于检查顺序,不由语法导向性单独决定.type_of
type_of
在失败时只返回
None
None
,把这些信息丢掉了. 要保留它们,只需把返回类型从
Option<Type>
Option<Type>
换成
Result<Type, Error>
Result<Type, Error>
, 在每个
?
?
和比较失败处记下当时的规则、子项和两个类型.
step
step
恰好实现一步关系. 因此,原则上可以反复规约任意输入,到达唯一正规形式后检查它是否为值, 精确判定求值是否受阻;也可以把这一计算放在编译期. 这个数学算法不会无限等待,但采用的是求值分析,不是原来的七条类型规则; 实际 Rust 执行仍采用
算术语言形式化的未展开前提
的资源与基础操作假设.
6.2
反演:从结论倒推前提
项的形状 结论里出现这个形状的规则 条数 T-True 1 T-False 1 T-Zero 1 T-If 1 T-Succ 1 T-Pred 1 T-IsZero 1
type_of
type_of
用单个类型就能表示规则给出的结果, 而不必返回类型集合. 没有唯一性,单个返回值可能只挑出了众多类型之一. 例如带子类型的 Kotlin 中,
Int
Int
表达式也可以出现在需要
Number
Number
或
Any
Any
的位置; 那样的系统通常要另外区分推断出的类型和它能充当的所有类型,不能照搬本文的结论.
6.3
练习:类型
Exercises (4)
Hint
最外层用 T-If;条件从 T-IsZero 开始,两个分支都应得到 .Solution
Solution
Hint
先反演 T-If,再连续反演 T-Pred 和 T-Succ; 整项的 由其中一个分支确定.Solution
通过典范形式引理、进展定理与保型定理,证明算术语言的良类型词项求值不会受阻. “良类型的程序不会出错”这句话, Robin Milner 在 1978 年说成 well-typed programs cannot go wrong. 要把它写成精确命题,必须先规定“出错”是什么: 本文只指规约到受阻状态,即非值且没有后继的词项 (
正规形式与受阻
). 这不是对异常、资源耗尽或业务逻辑错误的笼统保证. 要证明的类型安全性表达了类型规则与执行规则之间的协调. 文献常把这类保证称为类型健全性;本文在这一“不受阻”的意义下使用它. 它与检查器相对类型规则的“算法可靠性”不是同一个命题.
采用
类型与类型判断
的类型关系、
多步规约
的运行关系, 以及
正规形式与受阻
的受阻判定. 称这套语言规则具有类型安全性,如果对任意词项 、 和类型 : 若 且 ,则 没有受阻. 这个性质表达了类型规则相对于执行规则的类型健全性: 良类型词项的执行不会进入所定义的错误状态. 它不直接涉及某个具体检查算法,也不承诺终止或排除真实语言中的所有运行时错误. 注意这句话里的量词:对所有良类型的 ,对所有它能多步规约到的 . 这正是
量词的范围
提醒过的地方; 写成符号以后,范围就不会有歧义. 直接证明这个命题不好下手,因为 可以规约任意多步. Andrew K. Wright 与 Matthias Felleisen 在 1994 年给出的办法,是把它拆成两条只涉及一步的定理: 两条缺一不可.
规约到受阻
里的 现在能规约, 一步规约之后就受阻了. 只有进展,挡不住这种情况;只有保型,挡不住一开始就受阻的项. 这个例子本身没有类型,所以它不是两条定理的反例,只是用来说明为什么两条都需要. 证明进展时需要知道:某个类型的值长什么样.
这条引理把静态信息和动态信息连了起来. 它的前提 是类型信息,类型检查器不运行程序就能在编译期得出; 它的结论“ 是 或 ”是形状信息, 说的是这个值具体长什么样,而求值规则只认形状. 进展的证明正是靠它,从“条件是 类型的值”推出“条件确实是 或 ”, 才能选择 E-IfTrue 或 E-IfFalse. 反过来,若随意加一条定型规则 ,却不改求值规则, 就能通过类型检查; 但没有任何求值规则能处理它,所以会受阻: 类型说它是布尔值,形状却不是已有的求值规则要的 或 . 动态语言在运行时做的种类检查,正是在实际运行到该位置时才检查这类形状条件.
“静态”指不运行程序就能知道的性质,“动态”指运行时才能观察到的性质. 按类型检查发生在什么时候,程序语言大致分成两类: 用
词项的集合
的布尔值与自然数语言作类比, 一种动态检查的设计是不预先构造 的推导, 而是在 里给不合适的运行时操作补上报错规则 (
显式错误规则与 Kotlin 的底类型
), 把受阻换成可预期的异常. 另一种设计可以采用转换规则 (
JavaScript 隐式转换与相等三角图
). 真实语言往往同时有这两类处理; JavaScript 的条件还会采用真假值转换,不要求参数字面上就是布尔值. 对这门小语言的运算,类型规则、
典范形式
与
保型
合起来保证: 参数若要求为 ,求值为值时就一定是数值,所以不必在运行时再检查它是否为布尔值. 这不等于真实静态类型语言可以省掉所有运行时检查; 例如 Kotlin 仍会抛出数组越界异常,Rust 的数组索引也可能需要边界检查. 两者的取舍是:静态检查更早排除它所覆盖的错误, 但会拒绝一些实际运行不会出错的程序(
类型系统是保守的
); 动态检查更灵活,但错误通常要等到运行到那一行才暴露. 静态检查发生在运行前,不等于它能排除所有运行时错误. C 使用静态类型检查,但这种检查不能排除越界访问、通过悬垂指针访问对象等未定义行为 (参见 C11 草案 N1570 §6.2.4、§6.5.6).
类型安全
证明的“类型安全”, 表达的是这套类型规则相对于操作语义的类型健全性, 需要由具体规则及证明支撑,不靠未说明判准的“强类型/弱类型”标签. 延伸阅读可参见 FrankHB 的 类型 vs. 类型检查. 进展回答的是“类型检查通过以后,下一步会不会无规则可用”. 没有它,检查器即使给出了类型,也未必挡住 这样的错误. 具体地,若把 T-Succ 的前提错误放宽成 , 这个项就会得到类型 ,却既不是值也不能规约. 进展还必须允许“已经是值”这个分支,否则 这种合法结果反而会判为失败. 对于有异常的真实语言,则要先明确哪些异常是许可的结果, 不能把本文的进展原封不动当作“永不抛异常”.
采用
类型与类型判断
的类型关系、
值与数值
的值定义, 以及
一步规约
的规约关系. 若 ,则 是值,或存在 使 . 对 作规则归纳 (类型推导版本的
规则归纳法
), 按最后一步的规则分情形. T-If:,前提里有 .对 用
归纳假设
:
采用
类型与类型判断
的类型规则 和
一步规约
的求值规则. 取良类型的项 , 跟着
进展
的证明走一遍: 证明不只说“能规约”,还构造出了这一步的推导. 对 再用一次进展: 子项 是值,由
典范形式
它是数值, 且形如 succ nv,于是用 E-PredSucc 得到 . 对 再用一次进展:它是值,停止. 看 为什么会受阻,再对照证明: 要让它不受阻,要么 能规约,要么 是数值,两者都不成立. 证明之所以没遇到这个麻烦,是因为 T-Succ 要求 , 再经由典范形式把 限定为数值. 类型系统正是在这里把坏程序挡在门外的. 进展只能保证当前状态能运行,保型则让这个保证在运行后仍然可用. 若修改 E-PredZero 为 , 原有类型规则仍会给 赋予类型 ,第一步也可以执行; 但它会变成没有类型且受阻的 . 所以一次正确的类型检查必须能跨越每次运行时改写,不能“第一步安全就算安全”. 编译器的优化、解释器的执行规则也要维持相应的不变量, 否则即使前端检查器正确,后端仍能制造坏状态.
采用
类型与类型判断
的类型关系 和
一步规约
的规约关系. 若 且 ,则 . 对 作规则归纳(
规则归纳法
),对 一般化. 每个情形先对 使用
反演
.
下面的推论把“当前不受阻”和“下一项仍有类型”接成对任意有限运行前缀的保证. 只证明进展而不证明保型,保证可能一步后失效; 只证明保型而不证明进展,则起初就受阻的良类型项没有任何一步可走, 保型的条件从未成立,不能排除它. 这个推论保证的是本文定义的“不受阻”, 不保证程序一定终止,也不保证业务逻辑正确, 例如得到 是否符合程序员的意图.
类型安全本身不保证终止,但
规约使大小严格下降
已经另外证明了本文每条规约链都有限. 把它与进展、保型和确定性接起来,还能得到更完整的求值结论: 每个良类型项都会到达唯一的同类型值.
采用
词项的集合
的有限项、
值与数值
的值、
多步规约
的多步规约, 以及
类型与类型判断
的类型规则. 若 ,则存在唯一的值 ,使得 存在性.从 出发,只要有后继就继续规约. 由
规约使大小严格下降
,每步大小严格下降, 规约链至多有 步,因而必能到达没有后继的项 . 由
保型
对链长归纳,得 . 再用
进展
: 是值或还能规约; 后一种情况已经排除,所以 是具有类型 的值. 唯一性.设 且 ,其中 、 都是值. 对第一条链的长度归纳;归纳性质允许第二条链任意长.
类型安全
只排除受阻,不独自保证终止. 这条推论还用到了另行证明的终止性与确定性; 它针对上述未扩展语言,不能直接推广到含一般递归或其他求值规则的语言.
在
类型安全
的证明里, 我们一次也没有运行程序,却得到了关于所有运行的结论. 这让人想起 Immanuel Kant 的问题: 有没有不靠经验、却又对经验有效的知识? 这里的答案相当朴素. 结论之所以不靠逐个试验,是因为“运行”本身就是用规则定义出来的 (
一步规约
),定理只是把定义里已经包含的后承展开. 按逻辑实证主义的说法,这类命题是分析的:它的真依赖于定义. 但这不等于它空洞. “所有良类型程序都不受阻”在定义里并不显眼, 要靠反演、典范形式、两层归纳才能推出来,中途还可能发现定义写错了 (
分支顺序里藏着证明
和
为什么 E-PredSucc 要求 nv
就是例子). Gottlob Frege 在 Die Grundlagen der Arithmetik(《算术基础》)中比喻说, 结论可以“像植物包含在种子里那样”包含在定义中, 而不是“像梁木包含在房子里那样”一眼可见. 另一面是:证明只对这套规则成立. 真实的处理器是否遵循这些规则执行,是另一个问题. 实现这一层也可以继续建模并证明语义保持: 例如 CompCert 手册说明,它证明的语义保持定理以预处理、解析、类型检查和繁化之后的 CompCert C 语法树为起点,以汇编、链接之前的 Asm 语法树为终点, 这些前后阶段不在该定理的范围内 (见 CompCert C 手册第 1 章). 证明总是相对于某个模型成立; 模型与真实硬件、工具链之间的对应属于经验性假设,需要明确指出,并靠测试和工程去检验. Exercise 5.1. 把进展与保型放到同一条链上 四步依次用 E-If + E-IsZero + E-PredSucc,E-If + E-IsZeroZero, E-IfTrue,E-PredZero. 每个非末项都展示了进展要求的一个后继,末项 展示了“已经是值”的分支. 第一步内层 从 保持为 , T-IsZero 重建条件的 ,T-If 再和两个 分支重建整项的 . 第二步条件变成 ,分支不变; 第三步选出的 本来就在 T-If 的前提里具有 ; 第四步由 T-Zero 得 . 这才是类型为何保持的逐步解释,不只是把相同的标签写在每一行旁边. Exercise 5.2. 扩展:只有一条安全性定理够吗? 删除 E-PredZero 而保留其他规则时, 既不是值也没有后继,进展失效. 但剩下的每一步仍是原语言合法的步骤,因此仍保型. 保型无法排除一个根本没有步骤的坏终点. 将 E-PredZero 改为 时, 走到 ,保型失效. 原来的进展证明仍能为每个良类型非值找到一步, T-Pred 的零参数情形只是把后继换了一个;但它不保证后继仍良类型. 例如 在第二种修改下走到受阻的 . 所以“现在有下一步”与“类型保证能传到下一项”必须一起使用, 见
类型安全
. Exercise 5.3. 保型能倒过来读吗? 不成立. 取 , E-IfTrue 给出 ,且 ,但 没有类型: T-If 要求两个分支具有同一类型,而 与 的类型不同. 这不违反保型,因为保型的前提是起点已有类型. 从一个正常的终点倒推起点有类型,相当于把单向蕴涵改成了逆命题,
类型系统是保守的
已经提醒过不能这样用. Exercise 5.4. 扩展:不受阻,仍然可以永远运行 新规则是 . 仍不是值,始终有下一步,所以没有受阻; 每一步又回到同一个具有 的项,因此这条链一直保持类型,却永不结束. 原进展证明的 T-Pred 零参数情形仍有后继; 原保型证明的 E-PredZero 情形改为“结果就是起点,已有 ”. 其他情形不变,所以这门修改后的语言仍可证明进展、保型与不受阻的类型安全. 但大小始终为 ,原语言“每一步严格变小”的论证不能再用, 求值循环也不能再保证停止. 类型安全没有承诺终止;要证明终止,还需要另外的下降度量或其他证明.
7.1
先把命题写下来
7.2
典范形式
7.3
进展
7.4
保型
7.5
合起来
7.6
练习:类型安全
Exercises (4)
Hint
每个中间项都为 ;条件内部先保持 ,外层 保持 , 不能把这两个类型混成一个固定的 .Solution
Hint
分别修改,不要把两种修改混到同一门语言里. 保型只对实际存在的规约步骤作保证.Solution
Hint
从“分支类型不同,但运行选中一个正常分支”的项开始寻找.Solution
Hint
把 E-PredZero 改成自循环步骤,但不保留它原来规约到 的版本. 检查下一步是否存在、类型是否改变、大小是否下降.Solution
将语法导向的类型规则实现为 Rust 类型推理函数,并证明它相对类型规则可靠且完备.
类型与类型判断
用逻辑规则定义类型关系: 哪些 可以推出类型判断. 它并没有直接给出搜索推导的程序,更没有仅凭符号形式就保证类型检查可判定. 同一个关系,还可以按给定的是词项还是类型,提出不同的问题:
固定一套类型规则和语境 ,考虑类型判断 . 记录变量的类型假设,记号见
类型与类型判断
. 三种问题的区别在于给定什么、要找什么,不是另换三套类型规则: 把
良类型
的良类型定义写成带语境的形式, 问的就是:固定词项,是否存在类型,即 . 居留性问的是:固定类型,是否存在词项,即 . 不要把两个存在量词的位置看反: 推理找的是类型,不是程序; 居留性判定只需回答有无,若还要返回一个居留者,就进一步成了构造词项的问题. 例如,采用
类型与类型判断
的七条规则:
Rust 算法
常见误区 “检查失败,就说明这个项没有任何类型.” 检查针对的是某个给定类型. 不成立,只排除了 ;这个项仍有类型 . 要说它不良类型,必须排除所有可能的类型,不能把“不是期望的类型”说成“没有类型”. “推理器没有给出类型,就证明规则里不存在类型.” 把算法的拒绝解释成“规则无法定型”,需要相对规则的完备性. 在
算术语言形式化的未展开前提
的实现假设下, 这里的
“类型推理就是运行程序,看看结果是什么类型;不写标注就是动态类型.” 这套算术语言的推理按项的语法和类型规则分析,不执行 来观察结果. 静态类型系统也可以推理出省略的类型标注; 检查与推理的区别在于是否给定期望类型, 静态与动态的区别则在于检查何时发生,见
静态类型与动态类型
. “推理返回的就是唯一类型,检查时比较相等总是够用.” 唯一性是这套规则已经证明的性质,不是“类型推理”这个词自带的保证. 例如,若在七条规则外增加“由 推出 ”的转换规则, 就同时具有这两个类型. 只返回 再与期望的 比较,会误拒绝在扩展规则下成立的判断. 带子类型或多态的系统可能需要子类型判定、实例化等步骤; 若还要求推理返回最一般的主类型,也必须另行定义“更一般”,并证明主类型存在. “能检查或推理,就能判定类型居留性;几个候选都失败,就说明类型不可居留.” 检查、推理已经拿到了项,居留性却要问是否存在任何合适的项. 否定单个候选不能否定存在性; 候选可能有无穷多个,只靠逐一枚举、检查,也未必能在没有居留者时停下来回答“没有”. 反过来,这也不说明居留性总是不可判定:这套算术语言的两个类型都有现成见证. 三种问题是否可判定,要针对具体系统分别论证. “语境中能找到居留者,就已经找到了不依赖假设的程序.” 在含变量的语言中,若 已有 ,变量 就可在这个语境中居留 ; 去掉该假设后,判断未必仍成立. 没有另外指定语境时,说“ 可居留”通常指存在闭项 (没有自由变量),使 .
词项的集合
的算术语言没有变量,所有词项都是闭项,因此这里取空语境. “有居留者,就有一个正常的值,而且程序一定能算出它.” 这里的居留者是具有类型的项,不要求它已经是值. 在允许一般递归或异常的语言中,项有类型也可能永远循环或异常退出, 不能据此断言会正常返回该类型的值. 相应地,“底类型没有正常值”不等于“没有表达式能具有底类型”, 具体例子见
显式错误规则与 Kotlin 的底类型
. 可以把判断看作算法规范,分析其中的信息流:这里 是输入, 是待求的输出. 对本文的语法导向规则,每种词项构造都对应一个递归分支, 因此可以写出 Rust 函数
这个函数和规则之间隔着一道缝. 写代码的人会觉得“显然一样”, 可这正是
不完整的规格
之后一直在提防的词. 比如有人把
以
类型与类型判断
的关系 为规格, 以
Rust 类型检查算法
算法可靠性保证报告的类型判断都能由规则推出, 完备性保证规则认可的类型判断不会遗漏. 两者针对的是算法与类型规则的对应; 再加上对所有输入的终止性,算法才恰好判定这个关系. 下节先检查这项终止性前提.
英文 soundness 在这组形式化中涉及两种不同的对应. 译名之外,更重要的是写清谁相对于什么成立: 两条串起来,才能得到:检查器接受的程序,执行时不会受阻. 若算法错误地接受了不良类型词项,类型健全性无法替它作保证; 若规则本身不能排除受阻,正确实现这些规则也不足以保证运行安全. 两者的组合见
检查器接受的程序不会受阻
. 这里将 type soundness 译作“类型健全性”,而算法相对规则的 soundness 称“可靠性”. 文献可能使用其他译名;不要仅凭同一个英文词或中文译名就把两个命题混为一谈. 先确认一条隐含前提:把
首先证明可靠性,因为类型安全定理说的是“规则能推出类型的项”, 不是“某个函数返回
取
Rust 类型检查算法
对 结构归纳(
归纳证明的写法
).
可靠性还不够保证“算法与规则一致”: 对所有输入都返回
取
Rust 类型检查算法
对 作规则归纳,按最后一步的规则分情形. 两个证明的方向不同,归纳对象也不同: 可靠性跟着算法走,对输入词项作结构归纳; 完备性跟着类型推导走,对规则作归纳. 前者利用递归调用的结构,后者利用判断可推导时最后应用的规则. 最后要把两个不同的保证接起来:算法符合类型规则,类型规则又与运行规则协调. 少了第一段,错误检查器可能乱接受;少了第二段,类型系统可能认可运行时受阻的项. 这个端到端结论才是使用者真正需要的“检查通过以后能相信什么”, 也说明只证明某个局部函数正确不足以替整条链作保证.
取
Rust 类型检查算法
这一条就是
类型健全性与算法可靠性
说的完整链条. 完备性没有出现在这里,因为完备性保证的是检查器“不漏掉好程序”,而非“安全”. 这一节的证明顺利,靠的是
反演
依赖的那个性质: 规则是语法导向的,而且每条规则前提里出现的类型,都能从子项算出来. T-If 里的 由 算出,然后拿来比较 ,没有哪一步需要凭空猜一个类型.
类型判断首先由逻辑规则规定,不能仅凭规则写成了横线上下的形式, 就断言存在可判定的检查算法. 把判断用作算法规范时,须说明哪些量是输入、哪些量是输出,以及输出怎样求得. 例如,对没有参数类型标注的 (记号见
求值策略、规约策略与合流性
), 若想仅从词项推理其类型,参数 的类型不能直接从语法中读取; 把函数抽象规则直接照抄为递归分支,就留下了“该填哪个类型”的问题. 这不说明这个系统一定不可判定,而是需要类型标注、约束求解或从期望类型传入信息等额外设计. 带标注的 则已经在词项中给出了参数类型.
类型与类型判断
的布尔值与自然数语言避开了这一问题: 候选规则由语法形状确定,所需类型可由子项算出. 但其算法仍要证明终止性,以及相对规则的可靠性和完备性; 精确定义一个关系与给出判定它的程序,是两项不同的工作. 更大的系统也可能显式划分信息流. 双向类型检查把通常的类型判断分成检查判断 与推导判断 : 检查时 是输入,推导时 是输出; 是共同的输入语境. 这里的箭头标记类型信息的方向,不是词项的执行步骤. 本文的
逻辑学里也有一对“可靠/完备”,但要先说明“真”在哪些模型中成立. 设 是一组一阶句子, 是单个句子: 表示能从这些前提形式地推出 ; 表示每个满足 的模型也满足 . 证明系统的两个方向是: 两者合起来就是 . Kurt Gödel 在 1929 年的博士论文中证明了经典一阶逻辑的完备性; 这里说的是所有模型中的语义后承,不是某个预期模型中的一切真命题. 定义与定理可参见 Logic and Proof §10.5. 1931 年的不完备定理讨论的是另一个问题. 采用后来 J. Barkley Rosser 改进的表述: 一致、可有效公理化且具有足够初等算术能力的理论,不能决定其语言中的每个句子, 即存在某个句子,它与它的否定都不能在该理论中证明. 若说“真而不可证”,这里的“真”指标准自然数模型,“不可证”则相对于指定理论; 这不是绝对不可证明,也不表示一阶逻辑漏掉了在所有模型中成立的结论. 原始 Gödel 版本与 Rosser 版本的前提不同,参见 SEP: Gödel’s Incompleteness Theorems. 还要区分完备性与可判定性: 语义后承都有证明,不等于存在对每个输入都能停机并回答成立与否的算法.
可靠与完备
描述的类型检查算法与类型规则之间的关系, 只在“两个方向的对应”上与此平行:
Exercise 6.1. 可靠与完备守的是不同方向 对所有输入返回
对所有输入返回
C 只接受三个常量并返回它们正确的类型,其余返回
Exercise 6.2. 漏掉条件种类的检查 若
错误检查器会给 返回
修复是恢复条件种类的比较: 这处遗漏本身不会破坏完备性: 对原规则认可的项,条件确实为
Exercise 6.3. 检查顺序不同,会改变程序的运行吗? 可以在保持全部条件检查的前提下,先检查条件,再检查两个分支.例如: 原版与此版恰好都要求:条件为
这不会改变
Exercise 6.4. 实现一个带期望类型的检查接口 若
8.1
规则不是程序
问题 给定 要回答或寻找的内容 类型检查 、项 、类型 判断 是否可推导. 类型推理(也称类型推断) 、项 找出某个 ,使 ;没有这样的类型则报告失败. 类型居留性 、类型 判断是否存在某个项 ,使 .若存在, 称为该类型的居留者. type_of(t) -> Option<Type>
type_of(t) -> Option<Type>
按输入与输出划分是推理接口:给它词项,它返回类型. 它也常广义地叫作“类型检查器”,因为它同时判定项是否良类型. 带期望类型的检查接口则是
check(t, expected) -> bool
check(t, expected) -> bool
. 在这套规则下,可以用
type_of(t) == Some(expected)
type_of(t) == Some(expected)
实现它; 这依赖
类型唯一
, 以及算法相对规则的
算法可靠性
与
算法完备性
. 实际的检查器也可以交替使用检查与推理; 接口的区分,不要求实现拆成两套互不相干的算法.type_of
type_of
终止且相对规则完备,所以正常返回
None
None
确实表示项不良类型; 但在其他系统中,推理器可能只支持规则的一个子集,或要求额外标注. 缺少标注、超时、资源不足或搜索尚未结束,都不能直接当作无类型的证明.type_of
type_of
. 它接收词项、返回类型,严格说是类型推理接口;我们也沿用“类型检查器”这个广义称呼. 若调用者同时给出期望类型 ,再判断 是否成立,那才是狭义的类型检查.#[derive(Clone, Copy, Debug, PartialEq, Eq)]
pub enum Type { Bool, Nat }
/// 类型推理接口:返回 Some(T) 表示“t 的类型是 T”,None 表示拒绝.
pub fn type_of(t: &Term) -> Option<Type> {
use Term::*;
match t {
True | False => Some(Type::Bool), // T-True / T-False
Zero => Some(Type::Nat), // T-Zero
Succ(t1) | Pred(t1) => { // T-Succ / T-Pred
(type_of(t1)? == Type::Nat).then_some(Type::Nat)
}
IsZero(t1) => { // T-IsZero
(type_of(t1)? == Type::Nat).then_some(Type::Bool)
}
If(c, a, b) => { // T-If
let ta = type_of(a)?;
(type_of(c)? == Type::Bool && type_of(b)? == ta).then_some(ta)
}
}
}#[derive(Clone, Copy, Debug, PartialEq, Eq)]
pub enum Type { Bool, Nat }
/// 类型推理接口:返回 Some(T) 表示“t 的类型是 T”,None 表示拒绝.
pub fn type_of(t: &Term) -> Option<Type> {
use Term::*;
match t {
True | False => Some(Type::Bool), // T-True / T-False
Zero => Some(Type::Nat), // T-Zero
Succ(t1) | Pred(t1) => { // T-Succ / T-Pred
(type_of(t1)? == Type::Nat).then_some(Type::Nat)
}
IsZero(t1) => { // T-IsZero
(type_of(t1)? == Type::Nat).then_some(Type::Bool)
}
If(c, a, b) => { // T-If
let ta = type_of(a)?;
(type_of(c)? == Type::Bool && type_of(b)? == ta).then_some(ta)
}
}
}x.then_some(y)
x.then_some(y)
的意思是“条件
x
x
成立就返回
Some(y)
Some(y)
,否则返回
None
None
”.If
If
分支写成只检查
a
a
、不检查
b
b
,大多数手写测试照样能过. 要把“一样”说清楚,得拆成两个方向.
type_of
type_of
为实现. 在
算术语言形式化的未展开前提
的实现假设下, 正常返回
Some(T)
Some(T)
表示算法报告类型 ,
None
None
表示拒绝; Rust 的
Bool
Bool
、
Nat
Nat
分别对应对象语言的 、.type_of(t) = Some(T)
type_of(t) = Some(T)
,则 .type_of(t) = Some(T)
type_of(t) = Some(T)
.
type_of
type_of
的这一性质见
算法可靠性
, 一般定义见
可靠与完备
.
8.2
证明
type_of
type_of
看作有限项上的数学算法时,它会终止. 每次递归调用的参数都是
直接子项与真子项
中的直接子项, 所以由
大小与深度
后面关于结构递归的讨论,不会出现无限递归. 对实际 Rust 实现,这个论证采用
算术语言形式化的未展开前提
的资源与基础操作假设; 它没有保证任意深的输入都不耗尽机器的栈或内存.Some
Some
的项”. 若检查器在
If
If
分支里忽略 分支, 就可能接受 ; 程序下一步变成受阻的 . 类型规则本身没有错,错的是算法冒称规则已接受它. 下面的定理防止这种“假阳性”.
type_of
type_of
, 类型关系采用
类型与类型判断
. 实现论证采用
算术语言形式化的未展开前提
的资源与基础操作假设; Rust 的
Bool
Bool
、
Nat
Nat
分别对应 、. 对任意项 和类型 :若
type_of(t) = Some(T)
type_of(t) = Some(T)
,则 .type_of
type_of
本身按项的形状分支,所以每个情形对应一个分支.True
True
、
False
False
分支返回
Bool
Bool
,
Zero
Zero
分支返回
Nat
Nat
, 分别是 T-True、T-False、T-Zero 的结论.Some(Nat)
Some(Nat)
只有一种可能,即
type_of(t1) = Some(Nat)
type_of(t1) = Some(Nat)
. 由
归纳假设
得 ,用 T-Succ 得 . 、 同理,分别用 T-Pred、T-IsZero.Some(ta)
Some(ta)
说明
type_of(c) = Some(Bool)
type_of(c) = Some(Bool)
、
type_of(a) = Some(ta)
type_of(a) = Some(ta)
、
type_of(b) = Some(ta)
type_of(b) = Some(ta)
. 三次使用
归纳假设
分别给出 、、( 即
ta
ta
), 正是 T-If 的三个前提.None
None
的检查器也是可靠的,却连 都不接受. 完备性排除这种“假阴性”,保证实现不会漏掉规则认可的程序. 例如把 T-Pred 对应的代码分支误写成直接返回
None
None
, 不会放进坏程序,却会拒绝 这样的合法程序;下面这条定理能发现它.
type_of
type_of
, 类型关系采用
类型与类型判断
. 实现论证采用
算术语言形式化的未展开前提
的资源与基础操作假设; Rust 的
Bool
Bool
、
Nat
Nat
分别对应 、. 对任意项 和类型 :若 ,则
type_of(t) = Some(T)
type_of(t) = Some(T)
.type_of
type_of
即得.type_of(t1) = Some(Nat)
type_of(t1) = Some(Nat)
,于是
Succ
Succ
分支返回
Some(Nat)
Some(Nat)
. T-Pred、T-IsZero 同理.type_of
type_of
在三个子项上分别返回
Bool
Bool
、
T
T
、
T
T
. 代入
If
If
分支:
ta = T
ta = T
,两个比较都成立,返回
Some(T)
Some(T)
.
type_of
type_of
, 以及
多步规约
的关系 . 若
type_of(t) = Some(T)
type_of(t) = Some(T)
且 , 则 不会处于
正规形式与受阻
定义的受阻状态.
8.3
为什么这里这么顺利
type_of
type_of
与练习中的
check
check
展示了两种接口, 但尚未定义一套双向类型规则,不能只因同时有这两个函数就称它为双向类型系统.
type_of
type_of
是机械的求解过程,类型规则是规格. 这里比较的是算法与规则,不是比较证明与模型中的真.
算法可靠性
与
算法完备性
分别证明两个方向, 再加上算法的终止性,才得到判定过程. 更大的类型系统可能需要额外标注、约束求解或受限制的算法; 哪些保证能够保留,要针对具体规则另行论证.
8.4
练习:规则与算法
Exercises (4)
None
None
;B 总返回
Some(Nat)
Some(Nat)
; C 只接受 、、 并返回正确类型,其余返回
None
None
. 判断每个检查器相对原类型规则是否可靠、完备;凡不成立的方向,都给出反例.Solution
None
None
的 A 是可靠的:可靠性的前提从不成立; 但它不完备,因为 遭到拒绝.Some(Nat)
Some(Nat)
的 B 既不可靠也不完备. 它为 报告 ,规则只能给出 ,所以不可靠; 成立却没有返回
Some(Bool)
Some(Bool)
,所以也不完备. 它还会接受根本没有类型的 .None
None
. 它可靠,但不完备: 就是漏掉的合法项. 可靠性允许少接受,完备性不允许漏掉规则认可的判断.type_of
type_of
的
If
If
分支写成下面这样,其余分支不变, 找出一个错误接受的项,指出漏了 T-If 的哪个前提,并修复代码. 这个修改是否也必然破坏完备性?If(c, a, b) => {
let ta = type_of(a)?;
type_of(c)?;
(type_of(b)? == ta).then_some(ta)
}If(c, a, b) => {
let ta = type_of(a)?;
type_of(c)?;
(type_of(b)? == ta).then_some(ta)
}Hint
让两个分支都是 ,却把条件也写成 ;再区分放进坏项与漏掉好项.Solution
Some(Nat)
Some(Nat)
: 两个分支相同,条件也能得到某个类型,所以三个调用都成功. 但 T-If 要求条件为 , 只能为 , 因此这个项没有类型,算法可靠性失效;运行时它也受阻.If(c, a, b) => {
let ta = type_of(a)?;
(type_of(c)? == Type::Bool && type_of(b)? == ta).then_some(ta)
}If(c, a, b) => {
let ta = type_of(a)?;
(type_of(c)? == Type::Bool && type_of(b)? == ta).then_some(ta)
}Bool
Bool
,修改前后的检查都会通过; 对子项的类型推导使用规则归纳,仍得到正确的输出类型. 但“好项仍能通过”不抵消“坏项也得以通过”.type_of
type_of
在
If
If
分支先检查
a
a
(即 分支). 能否改成先检查条件
c
c
,同时保持接受的项与输出类型不变?给出代码并论证. 这样的改动会不会让对象语言先运行 分支?Hint
本文的
type_of
type_of
没有副作用,总会终止,失败只返回
None
None
. 它的调用顺序不是对象语言的求值顺序.Solution
If(c, a, b) => {
    if type_of(c)? != Type::Bool { return None; }
    let ta = type_of(a)?;
    (type_of(b)? == ta).then_some(ta)
}If(c, a, b) => {
if type_of(c)? != Type::Bool { return None; }
let ta = type_of(a)?;
(type_of(b)? == ta).then_some(ta)
}Bool
Bool
、两个分支都有类型且相等. 每次调用都终止且没有副作用,所以最终
Some(T)
Some(T)
或
None
None
相同. 条件不合适时,此版只是更早返回
None
None
.step
step
的顺序: 检查器在元语言中分析整个项,求值器则按对象语言的规约规则运行. 若检查器改成返回详细错误,检查顺序可能改变首先报告哪个错误; 那是诊断接口的额外行为,不是本文
Option<Type>
Option<Type>
结果的区别.type_of
type_of
包装成检查接口
check(t, expected) -> bool
check(t, expected) -> bool
, 使它当且仅当原规则能推出 时返回真,其中
expected
expected
对应 . 证明两个方向及终止性,给出成功、期望类型不符和项本身不良类型三个例子.Hint
不必新增类型规则; 比较
type_of
type_of
的结果与
Some(expected)
Some(expected)
,然后分别使用算法可靠与完备.Solution
pub fn check(t: &Term, expected: Type) -> bool {
    type_of(t) == Some(expected)
}
pub fn check(t: &Term, expected: Type) -> bool {
type_of(t) == Some(expected)
}check(t, T)
check(t, T)
为真,
type_of(t)
type_of(t)
等于
Some(T)
Some(T)
, 由
算法可靠性
得 . 若 ,由
算法完备性
得
type_of(t) = Some(T)
type_of(t) = Some(T)
,比较为真. 两方向合起来就是
check(t, T) = true
check(t, T) = true
当且仅当 .∎type_of
type_of
结构递归并终止,最后一次类型比较也终止,所以
check
check
终止.
check(true, Bool)
check(true, Bool)
为真,
check(true, Nat)
check(true, Nat)
为假,
check(pred 0, Nat)
check(pred 0, Nat)
为真; 没有类型的 对两个期望类型都返回假. 这只是原算法的接口包装,没有增加一种对象语言的判断或求值策略.
把进展、保型与确定性写成基于样本的测试断言,并讨论测试与形式证明的边界. 纸面证明可能写错,代码也可能与规则不一致. 可以把定理在具体样本上的结论写成测试断言: 生成大量词项,检查它们是否满足进展、保型等性质. 这是在有限样本上核对实现,不是把普遍命题直接变成了测试证明.
规约使大小严格下降
证明的是原求值关系的每一步都让项变小, 测试却不能预先假定待测
完整工程在
确定性也能这样测. 测试里把十条规约规则逐条照抄成返回所有可能 的函数,不做任何排序或排除, 然后检查它在每个样本上至多给出一个结果,并且和
前文提过的两个错误写法都会暴露出来,但抓住它们的测试不同: 每条定理守住的东西不同,少证一条,就会漏掉一类错误.
测试只能检查有限个样本,证明则覆盖命题量词范围内的所有对象. 例如,
用测试对照证明
的测试样本来自
词项的集合
的词项集合, 深度按
大小与深度
计算; 深度为 3 的项已经多到难以及时穷举. 测试通过,只说明在这些样本上没找到反例. 两者的分工是:证明负责说明“为什么对”,测试负责检验“证明和代码说的是不是同一件事”. 测试失败时,要检查实现、测试断言及它们与规格的对应; 证明写不下去时,也不能据此断定一定有反例: 可能是命题本身不成立,也可能是缺少引理、归纳命题过弱或证明方法不合适,须继续分析. 真实软件也能说明测试规模与普遍保证的区别. 按 SQLite 官方测试说明的版本与口径, SQLite 3.42.0(2023-05-16)有约 155.8 KSLOC 的 C 库源码, 以及 92053.1 KSLOC 的测试代码与脚本,即约 15.58 万行与 9205.31 万行; SLOC 不计空行和注释.这是代码规模,不是覆盖率. 官方另报告特定配置下核心代码的 100% 分支覆盖, 但分支覆盖不等于覆盖所有路径、输入和状态,也不意味着没有任何缺陷. 路径数确实可能指数增长: 在无循环、顺序经过 个二路分支且所有分支组合都可达的情况下,可有 条路径. 但不是每增加一个
类型系统走的是另一条路.
类型安全
这样的定理不是对路径逐条检查, 而是一次性地对所有良类型程序、所有执行路径断言“不会受阻”. 这里证明的是类型健全性: 类型规则认可的词项,在执行时确实不会出现所定义的那类错误. 例如,C 的静态类型检查不能排除越界访问、通过悬垂指针访问对象等未定义行为, 所以“通过检查”不能作为内存安全保证,该测的还得测. 采用内存安全语言,是把一类错误的防线从测试移到语言机制上的工程选择. Rust 的类型系统与借用检查旨在阻止违反所有权、引用和并发访问约束的 Safe Rust 代码通过编译; 但它接触到的
RustBelt(POPL 2018) 给出了代表现实 Rust 子集的语言的机器检查安全证明, 并为内部使用
经验数据也支持采用内存安全语言的价值: Microsoft 的 2019 年报告 指出,每年修复并分配 CVE 的漏洞中约七成涉及内存安全; Chromium 的约七成则以自 2015 年起影响稳定通道的 912 个高危或严重漏洞为统计对象. 两份资料的严重性口径不同,不能合并成“各自所有产品的严重漏洞”. Android 的 2024 年报告 则指出,新开发转向内存安全语言后,这类漏洞的占比显著下降; 它主张优先保护新代码、改善安全互操作,并明确认为不必重写全部现有代码. 因此,这些材料更适合支持逐步采用内存安全语言. 是否用 Rust 重写某个既有工程,还须考虑具体风险、迁移成本与兼容性,不能单靠这组数据决定. 静态检查与形式证明仍不取代测试, 但在所声明的安全契约与模型假设下,它们可以排除一类有限样本测试无法单独排除的错误.
Karl Popper 认为, 经验科学里的普遍命题无法靠有限次观察证实,只能由反例证伪. 测试也有这样的边界:一万个通过的样本不能证实“所有良类型程序都不受阻”. 要反驳
类型安全
,反例必须同时满足: 其中前两个判断必须能由
类型与类型判断
与
多步规约
的正式规则推出, 受阻按
正规形式与受阻
判断. 单独找到受阻项并不够,例如 本来就不良类型; 错误的 Rust 实现产生受阻状态,反驳的可能是实现与规则的对应,而非原规则的类型安全. 证明则走另一条路. 它不靠抽样观察,而是从定义出发推出结论,所以可以对无穷多个程序负责. 代价是它只对定义负责: 如果规则本身没有描述我们想要的语言,证明再严密也帮不上忙. 这说明了证明与测试的分工:证明管“从规则到结论”,测试和实现管“规则是不是我们想要的”.
类型安全
与
用测试对照证明
分别给出了这两种工作的例子. Exercise 7.1. 给不同的错误配不同的测试 四处修改应分别注入、分别恢复,才能知道哪个测试在防哪类错误. 放宽规则的错误不一定破坏类型安全,不能指望一条安全测试包办所有性质. Exercise 7.2. 通过测试,还是没有真正测到? 只生成不良类型的项时,
至少统计并断言良类型样本数大于零、实际规约总步数大于零, 再加入确实需要多步运行的嵌套项. 还应单独测拒绝的项和受阻情形. 这些统计能排除明显的空转,却不等于覆盖所有规则和路径.
Exercise 7.3. 再多的有限样本也留下边界 假设这批样本非空, 就是有限的最大深度;空样本集可取 . 可以构造一个终止的错误检查器: 每个测试样本深度都不超过 ,所以它们得到的结果与正确实现完全相同. 可是给 外面包上 层 ,得到的项深度为 , 假检查器会把它接受为 ; 原类型规则却无法给最内层 定型,整个项没有类型,而且受阻. 因此有限测试通过,只能排除样本范围内已出现的反例. 这里不声称真实缺陷一定这样写,而是用具体构造说明: 没有关于所有项的证明,测试结果本身不蕴涵普遍可靠性. Exercise 7.4. 为什么求值测试的循环会停? 对 作规则归纳. E-IfTrue 与 E-IfFalse 只留下一个分支,删掉根、条件及另一分支,大小严格下降. E-PredZero 和 E-IsZeroZero 从两个节点变成一个; E-PredSucc 删除 与 两个节点; E-IsZeroSucc 把大小至少为 的项变成单个 节点. 这覆盖六条基本规约规则. 对 E-Succ、E-Pred、E-IsZero,
归纳假设
给出子项大小严格下降, 两边包上同一个一元节点,严格不等式仍成立. 对 E-If,只有条件变化,两个分支与 根贡献的节点数相同,也保持严格下降. 因此十条规则都给出 .∎ 大小始终是至少为 的整数,起点大小为 时,最多走 步就必须停止. 停止时是否为值是另一个问题:不良类型项也会停止,却可能受阻; 对良类型项,进展才排除这种终点. 深度不适合替代这个严格下降度量. 例如 的第一步 只把条件变成 ,最长路径仍在 分支,两项深度都是 . 类型安全也不独自保证循环停止,见本节之前的自循环扩展题.
#[test]
fn safety() {
    for t in corpus() {                        // 深度 ≤ 2 的全部项 + 随机的深项
        let Some(ty) = type_of(&t) else { continue };
        let mut cur = t.clone();
        loop {
            // 进展:不是值,就必须能规约
            let Some(next) = step(&cur) else {
                assert!(is_value(&cur), "受阻了:{cur:?}");
                break;
            };
            // 下降性质:待测实现返回的后继也必须严格更小
            assert!(size(&next) < size(&cur), "{cur:?} ⟶ {next:?}");
            // 保型:一步规约,类型不变
            assert_eq!(type_of(&next), Some(ty), "{cur:?} ⟶ {next:?}");
            cur = next;
        }
    }
}#[test]
fn safety() {
for t in corpus() { // 深度 ≤ 2 的全部项 + 随机的深项
let Some(ty) = type_of(&t) else { continue };
let mut cur = t.clone();
loop {
// 进展:不是值,就必须能规约
let Some(next) = step(&cur) else {
assert!(is_value(&cur), "受阻了:{cur:?}");
break;
};
// 下降性质:待测实现返回的后继也必须严格更小
assert!(size(&next) < size(&cur), "{cur:?} ⟶ {next:?}");
// 保型:一步规约,类型不变
assert_eq!(type_of(&next), Some(ty), "{cur:?} ⟶ {next:?}");
cur = next;
}
}
}step
step
已正确实现这个关系. 因此这里也检查
size
size
严格下降: 若错误实现返回原项,测试会报告失败,而不是永远循环. 它防范的是“每次调用都会返回,但后继不下降”的错误; 若
step
step
自己不返回或耗尽资源,仍需测试进程的超时或其他限制, 见
算术语言形式化的未展开前提
.code/plt-arith
code/plt-arith
下; 进入该目录运行
cargo test --release
cargo test --release
. 实际测试还保留
size(t)
size(t)
次调用的上限,并明确确认求值器曾返回
None
None
, 不能仅凭当前项是值就认定已经停止; 同时统计良类型样本与实际规约步数,防止测试空转. 样本是深度 2 以内的全部 59439 个项,外加 50000 个深度到 6 的确定性随机项.step
step
一致. 这同时验证了
分支顺序里藏着证明
的说法:
match
match
的分支顺序没有偷偷改变语义.type_of
type_of
不检查 分支,破坏的是检查器相对原类型规则的可靠性: 原规则的保型定理并没有推翻,推翻的是“检查器接受的项都满足规则”.
safety
safety
实际报出的反例是 : 错误的检查器只看 分支,认为它是 ; 一步规约(E-Succ + E-IfFalse)得到 ,没有类型,而且受阻了; 测试是通过“规约后类型不再保持”暴露这个检查器错误的.
if
if
都必然翻倍,条件之间可能相关,也可能有不可达分支; 循环还会带来不同迭代次数等问题. 这个例子说明逐路径穷举可能很昂贵,不说明测试无效,更不能单凭测试行数判断是否应当重写软件.unsafe
unsafe
库实现与外部代码仍须遵守相应安全契约. 通过编译不等于任意 Rust 工程都安全,更不保证没有逻辑错误、死锁或异常退出.unsafe
unsafe
的库规定验证条件,验证了其中若干重要库. 这与“整个 Rust 语言、编译器和所有工程都已证明安全”是不同的主张.
9.3
练习:测试与证明
Exercises (4)
Hint
分别检查值不可规约、进展、关系的所有后继,以及检查器接受后类型能否保持; 测试一个函数只有一个返回值不是确定性测试.Solution
step(True)
step(True)
返回
Some(Zero)
Some(Zero)
: 用值不可规约测试要求
step(True) == None
step(True) == None
. 这个错误也把
Bool
Bool
变成
Nat
Nat
,所以保型检查也能发现.step(Pred(Zero))
step(Pred(Zero))
返回
None
None
: 不是值,却无法走一步,进展测试会失败.step
step
选出的一个返回值.type_of
type_of
忽略 分支: 误判为 , 一步得到 ,新项没有类型且受阻. 逐步保型或端到端安全测试能抓到它.safety
safety
测试如果只生成不良类型项, 或者只生成 、、,会发生什么? 怎样用统计断言发现这种空转? 另解释为什么
assert_eq!(step(t), step(t))
assert_eq!(step(t), step(t))
, 或者从
step
step
直接包装出的“关系枚举器”,不能验证求值器与规则一致.Solution
let Some(ty) = type_of(&t) else { continue };
let Some(ty) = type_of(&t) else { continue };
会跳过每个样本,进展和保型断言一次都不运行. 只生成常量值时,类型检查会通过,但
step
step
立即返回
None
None
, 仍从未检查一次类型保持.assert_eq!(step(t), step(t))
assert_eq!(step(t), step(t))
只是一个确定执行的函数与自身比较; 即使它算错了,两边仍可能同时错. 把“关系枚举器”直接写成
step(t).into_iter().collect()
step(t).into_iter().collect()
也没有独立核对规则. 应分别按规则列出后继,再与函数实现对照; 两份代码仍可能犯相同错误,所以还需结合具体例子、逐规则审阅与证明.type_of
type_of
的所有结果对照, 却在某个更深的项上不可靠. 给出函数、反例和推理,说明这个例子揭示的测试边界.Hint
设这批样本的最大深度为 .让错误只在深度超过 时出现.Solution
pub fn bounded_fake(t: &Term, d: usize) -> Option<Type> {
    if depth(t) > d { Some(Type::Nat) } else { type_of(t) }
}
pub fn bounded_fake(t: &Term, d: usize) -> Option<Type> {
if depth(t) > d { Some(Type::Nat) } else { type_of(t) }
}Hint
对一步规约作规则归纳. 基本规约规则删掉节点;结构规则把子项的严格下降带到外层. 深度不一定严格下降.Solution
回顾从抽象语法、小步语义到类型安全与检查器可靠性的定义、归纳与证明链条. 全文走过的路,可以按“每一步依赖什么前文”串成一条线: 贯穿始终的方法只有一个: 先把东西定义成满足某些规则的最小对象,再沿着这些规则归纳. 语言变大以后,规则会变多,证明会变长,但这个方法不变. 它在数学和逻辑史上的来历,见
“最小 + 归纳”的历史
.
形式化入门:从 BNF 到类型安全
定义了布尔值与自然数语言,并证明其类型安全; 这套形式化仍有几项默认采用、未单独展开的前提: 本系列的布尔值与自然数语言、规则名称与证明主线以 Types and Programming Languages(TAPL)为基础. 术语译名以香蕉空间的条目为准, 香蕉空间尚未收录的术语参考下列两篇中文译文; 全部术语对照见
术语对照
. 参考译文不意味着把不同模型的规则或结论直接移植到本文.
step
step
、
type_of
type_of
及其辅助函数的纸面论证暂不考虑资源耗尽, 并假定模式匹配、分配、克隆、比较和析构等 Rust 操作按预期正常完成; 用
usize
usize
实现的大小与深度计数也假定不溢出. 结构递归排除的是数学上的无限递归,不保证任意深的项都能在实际机器上正常处理: 检查、克隆和析构同样会消耗栈或内存. 模型中的“没有后继”对应
None
None
,不把栈溢出、分配失败或程序异常退出也解释成
None
None
.step
step
与
type_of
type_of
相对规则的对应有纸面证明 (
求值器与一步规约一致
、
算法可靠性
、
算法完备性
),再配合测试, 但这些证明没有机器检查,也没有覆盖 Rust 语言本身的语义. 要做到机器检查证明,需要把规则和定理编码进 Coq(现名 Rocq)、Lean、Agda 等证明助手.
10.2
延伸阅读
Types
Types
一章 给出相近算术语言的形式化定义,讲解进展、保型和类型安全,并留下相关机械化证明练习. 公开代码中的
Admitted
Admitted
是待补全的证明,不是已完成的机检证明; 该章也不验证本文的 Rust 实现.
写作风格指引
[style]
- 2026-10-14
- Glomzzz
本站的中文写作、文章结构、术语与数学记号,以及 Typst/Typsite 源码约定.
- 2026-10-14
- Glomzzz
写作风格关乎读者怎样理解一篇文章:先看见问题,得到直觉再沿着定义、例子与论证核对细节. 本站用 Typst 写作,用 Typsite 组织和发布页面; 本文约定中文表达与源码写法,主要面向编程、数学与技术文章. 随笔可以保留个人口吻,不必套用概念条目的结构.
这些约定参考香蕉空间的《风格指引》,并按本站的工具与内容组织方式调整. 基本原则是:直观的解释要易读,精确的陈述要可核对,源码要便于维护. 这不是要求每篇文章都写成论文,也不是用排版代替论证.
1 写给正在学习的人
读者可能第一次接触这个概念,也可能熟悉相邻领域,却不熟悉这里的术语. 开头应交代讨论什么、它解决什么问题,以及读到哪里能找到准确陈述. 不要先堆满缩写、历史与技术条件,再让读者猜主题.
介绍概念时,先给简短的直观解释,再用定义或命题说明它的准确含义. 例如,介绍类型安全,可以先说: “类型规则与运行规则配合,使通过检查的程序不会遇到某类未规定的操作.” 随后必须说明使用哪套规则、“未规定的操作”指什么,以及保证成立的条件. 不能把这个直觉扩写成“通过类型检查的程序绝不会出错”: 逻辑错误、资源耗尽等问题未必在所述定理的范围内.
比喻可以帮助理解,但要指出它对应什么,在哪些地方不再适用. 例子说明某种行为,反例否定某个断言; 除非讨论的情形已经穷尽,若干例子或测试不能代替一般证明.
讲解与个人判断也应分开. “由这些规则可推出……”需要论证; “我更喜欢这种设计……”可以表达偏好,但不能因此声称其他设计错误. 有尚未核实的解释,就保留“可能”“在这个模型下”等必要限定.
2 文章的结构
2.1 引言
引言通常回答三个问题:主题是什么,为什么值得讨论,最简单的例子是什么. 概念文章可以从“在某个领域中,某概念是……”开始, 但不必把所有文章的第一句写成同一模样. 工程文章也可以从具体问题或失败的尝试开始.
主题首次出现在正文中时用粗体. 短概念的引言可以只有一句话;复杂主题则先交代阅读所需的背景, 把不影响理解的旁支留给补充说明或延伸阅读. 引言末尾可以简短指出它与相邻概念的联系.
2.2 定义或陈述
介绍概念的文章通常有“定义”一节;介绍定理时, 可以改成“陈述”或“陈述与证明”. 定义应准确、简洁,解释每个对象、记号、参数及其取值范围. 多个相关子概念可以分小节,不要塞进一个过长的句子.
命题要把假设和结论写全. 例如,“规约是确定的”应说明针对哪套规约规则, 以及“确定”表示下一步唯一,还是最终结果唯一. 不能把这类条件只放在引言里,再要求单独阅读命题的读者自行找回.
2.3 例子、性质与证明
例子从简单或边界情形开始,再到典型、有趣的情形. 数学文章可以先考察空集、零对象或一维情形; 程序语言文章可以先考察常量、单步计算、最小的错误项, 再展示嵌套构造与多步推导.
每个例子都应写清它使用的假设与记号. 即使几个例子采用同一套条件,必要时也应重复说明, 而不是为了少写一句话牺牲清晰度. 性质与命题同样如此.
证明先说明方法,再展开关键步骤. 使用归纳法时,交代归纳对象、归纳假设和覆盖的情形; 使用已有结论时,给出引用,并检查其前提在当前情形下成立. “显然”“容易验证”不能替代读者真正需要的推理.
工程文章可以采用“问题—约束—方案—实现—验证—局限”的顺序. 写清代码的输入、输出、失败行为和运行条件; 性能结论还应交代测量环境与比较对象. 没有做过的实验不要写成已经验证的结果.
2.4 讲解文章与独立条目
本站把可复用的定义、定理、例子及补充说明放在
root/statements/
root/statements/
, 讲解文章通过
statement
statement
嵌入,通过
refer
refer
引用. 不要为另一篇文章复制一份相同的定义或证明,再让两份内容逐渐分叉. 下面是一份使用现有条目的概念文章骨架:
#import "/lib/lib.typ": *
#import "/lib/statements.typ": statement, refer

#show: schema.with("page")

#title[理解类型判断]
#metacontent("description")[从具体例子理解类型规则怎样描述词项的类型.]
#date[2026-10-14]
#author[Glomzzz]
#parent("/how/index.typ")

在程序语言理论中,*类型判断*描述词项与类型之间的关系.
下面以布尔值与自然数构成的算术语言为例.

= 定义

#statement("definition/types-and-typing-judgments")

= 例子

#statement("example/well-typed-and-ill-typed-terms")

= 性质

#statement("theorem/progress")

根据 #refer("theorem/progress"),在所述规则下,
良类型的项要么已经是值,要么还能规约一步.#import "/lib/lib.typ": *
#import "/lib/statements.typ": statement, refer
#show: schema.with("page")
#title[理解类型判断]
#metacontent("description")[从具体例子理解类型规则怎样描述词项的类型.]
#date[2026-10-14]
#author[Glomzzz]
#parent("/how/index.typ")
在程序语言理论中,*类型判断*描述词项与类型之间的关系.
下面以布尔值与自然数构成的算术语言为例.
= 定义
#statement("definition/types-and-typing-judgments")
= 例子
#statement("example/well-typed-and-ill-typed-terms")
= 性质
#statement("theorem/progress")
根据 #refer("theorem/progress"),在所述规则下,
良类型的项要么已经是值,要么还能规约一步.独立条目应当能从自己的网址开始阅读. 不使用指向原讲解文章的“上文”“下一节”“这门语言”等含混指代; 需要哪个定义或哪套规则,就明确引用它.
parent
parent
只提供返回页面的关系,不能代替正文中的依赖说明.
条目的单文件结构、分类与命名详见仓库中的
root/statements/README.md
root/statements/README.md
; 实际用法也可参见
形式化入门
.
3 中文表达与排版
3.1 简洁、精确、自然
少用没有作用的量词和被动句,避免逐字搬运外文句式. 例如:
- 写“设 是集合 的子集”,不写“设 是一个集合 的子集”.
- 写“此时称 为光滑流形”,不写“此时 被称为光滑流形”.
- 写“该映射定义为……”,通常不必写“该映射被定义为……”.
- 写“域是带有加减乘除四则运算的集合, 这些运算满足实数、有理数的四则运算那样的性质”, 比反复使用“一个……是一个……其上……”更自然.
这不是禁用“一”“被”或长句. 需要强调数量、施事者不明,或必须保留原文语气时,可以照常使用. 删改句子时尤其要保留否定、范围、条件与确定程度: “可能减少开销”不能润色成“减少开销”.
一个段落尽量围绕一个问题. 列举并列内容时用列表,表达推理关系时用连贯的句子; 不要把所有论证拆成口号,也不要反复预告“接下来我们将深入探讨”.
3.2 标点、空格与强调
中文正文使用全角标点
,.;:?!
,.;:?!
:句号统一用全角西文句点
.
.
,不用空心句号
。
。
. 并列的词语或公式之间用顿号,例如“定义、例子与性质”、 “设 、、 是复数”. 引号用“”,嵌套时内层用‘’;书名用《》. 代码、网址和公式内部保留各自语法需要的半角标点.
中文与拉丁字母、数字之间通常留一个半角空格, 例如“用 Typst 写作”“共有 3 个分支”. 中文标点前后不额外加空格;行内公式不要靠连续空格调整位置.
强调中文用粗体,不用斜体. 粗体应帮助读者定位术语或关键条件,而不是给整段文字染上重点.
*粗体强调*,不要写成 Markdown 的双星号形式.
_斜体_适合确实需要斜体的外文,不用于强调中文.

变量写成 $x$,函数名写成 `type_of`.
代码中的关键字可以写成 `if`,公式中的关键字可以写成 $"if"$.*粗体强调*,不要写成 Markdown 的双星号形式.
_斜体_适合确实需要斜体的外文,不用于强调中文.
变量写成 $x$,函数名写成 `type_of`.
代码中的关键字可以写成 `if`,公式中的关键字可以写成 $"if"$.数学对象用数学模式,代码标识符用行内代码. 不要把数学变量写成代码,也不要用数学斜体拼出程序中的多字母函数名.
4 术语与名称
4.1 选取与统一
所有术语优先遵循香蕉空间的译名, 并在 术语对照 内标注英文与中文译名. 已有通用中文术语时,采用通用术语. 没有稳定译名时,优先考虑准确、易懂、符合汉语习惯的译法; 拿不准就先讨论,不要只为避开外文而创造难懂的新词. 同一概念在本站应尽量使用同一译名,以介绍它的条目为准. 本站将 effect 统一译作“作用”,algebraic effect 译作“代数作用”, 派生术语也统一使用“作用”.
尽量写完整术语. 例如,跨领域的文章应写“代数曲线”,而不是让读者猜“曲线”指哪一种. 某术语在一句话或一段话中反复出现,且不会引起歧义时,可以适当简称. 有意采用不同译名时,应解释对应关系与选择理由.
正文以中文术语为主,不用外文缩写代替已经清楚的中文名称. 行文时不要突然在术语后插入括号标英文; 除了在 术语对照 集中收录英文与中文译名外, 单篇文章也可将外文对照放在“术语对照”或“延伸阅读”一节, 直接使用 Typst 的描述列表:
= 术语对照

/ 类型判断: typing judgment
/ 结构归纳法: structural induction
/ 小步操作语义: small-step operational semantics
= 术语对照
/ 类型判断: typing judgment
/ 结构归纳法: structural induction
/ 小步操作语义: small-step operational semantics编程文章还需要保留读者检索文档、运行代码时使用的名字. Typst、Typsite、API 名称、命令、包名与代码标识符不强行翻译. 必要的缩写在首次使用时解释,后续不要在中文名称与多种简称之间随意切换.
4.2 人名、连接号与连字符
数学术语中的中文人名写成汉字;其他人名采用通用的拉丁字母拼写, 保留原有的变音符号与扩充字母,例如 Poincaré 群、Gauß 绝妙定理. 非拉丁文字的人名采用通用的拉丁字母转写; 国名、地名仍使用通用中文译名. 外文形容词式的人名后缀通常还原为人名, 例如 Abel 群、Riemann 几何.
连接两个人名用连接号“–”,例如陈–Weil 理论; 一个人名或单词内部用连字符“-”,例如 Levi-Civita 联络. 这些符号与中文破折号“——”用途不同,不要混用.
术语后半部分是完整术语、前半部分是补充条件时,通常加连字符, 例如 -模、-范畴、-有限. 同位关系不用连字符,例如 函数; “ 维空间”“ 进数”也不用. 不要机械复制英文术语中的每个连字符.
4.3 书名与文献
外文书首次出现时给出原语言书名,再给中文译名; 再次出现时可以只用中文书名. 引用书籍、论文或技术文档时,尽量给出作者、标题和稳定链接; 讨论具体结论时补充章节、命题编号或版本. 转述与直接引语应区分,自己的译文也应注明.
5 数学记号
优先使用通用记号. 不常见的记号在每一节首次使用时解释,同一对象尽量保留同一种主要记号. 不能因为读者可以点开链接,就省略当前推导所需的变量范围与假设. 有领域惯例或必须区分的语义时,应说明例外,不能为了统一字形改变含义.
映射与集合. 映射冒号应具有关系符号的间距; 集合的条件分隔符用竖线,不用冒号. 空集写作 .
$f class("relation", colon) X -> Y$ ${ x in RR mid(|) x > 0 }$ $emptyset$$f class("relation", colon) X -> Y$ ${ x in RR mid(|) x > 0 }$ $emptyset$希腊字母与常数. 采用 、 这两种字形, 对应 Typst 的
epsilonepsilon、phiphi,不要随意切换为.alt.alt变体. 数学常数 e、 i 用正体, 变量 、 则仍按变量排版. 微分中的 用斜体; Typst 的difdif默认用正体,不能不加说明地视为同一写法.$epsilon, phi$ $upright(e), upright(i)$ $d x$$epsilon, phi$ $upright(e), upright(i)$ $d x$包含与同构. 用
subsetsubset表示允许相等的包含, 用subset.neqsubset.neq明确表示真包含,并在首次使用时说明. 若当前领域用subset.eqsubset.eq表示允许相等的包含,则明确约定并保持一致. 同构一般写作 ,但要说明是哪类对象之间的同构.$A subset X$ $A subset.neq X$ $X tilde.eq Y$$A subset X$ $A subset.neq X$ $X tilde.eq Y$区间与序列. 开区间可采用反向方括号; Typst 中使用转义与
lrlr配对,不照搬 LaTeX 的括号命令. 一族对象要给出指标范围,不只写孤立的 .$lr(\]a, b\[)$ $(a_n)_(n >= 0)$ $(X_i)_(i in I)$$lr(\]a, b\[)$ $(a_n)_(n >= 0)$ $(X_i)_(i in I)$算子与字体. 算子名用
opop,而不是只把字母改成正体. 具体范畴一般用无衬线字体,一般范畴用花体; 线性群名、导出函子及来自单词的上下标用正体, 对称群、交错群可用哥特体.$op("coker") f$ $sans("Set"), A "-" sans("Mod"), cal(C)$ $upright("U")(n), upright("GL")_n, upright("R") f_*$ $bb(G)_upright("m"), H^upright("BM")$ $frak(S)_n, frak(A)_n$$op("coker") f$ $sans("Set"), A "-" sans("Mod"), cal(C)$ $upright("U")(n), upright("GL")_n, upright("R") f_*$ $bb(G)_upright("m"), H^upright("BM")$ $frak(S)_n, frak(A)_n$
行内公式尽量紧凑,避免高大的分式影响行距. 注意,Typst 的
a / b
a / b
会生成上下堆叠的分式; 若要写成斜线形式,应写
$a slash b$
$a slash b$
,而不是照抄 LaTeX 的源码习惯. 独立展示的公式可以使用
frac(a, b)
frac(a, b)
或
a / b
a / b
.
行内映射通常用短箭头
->
->
,行间映射可用
arrow.r.long
arrow.r.long
. 规约、蕴涵、等价等箭头各有含义,应先确定语义, 再决定字形与长度,不能把所有箭头统一替换.
6 Typst 与 Typsite 源码
6.1 页面入口与元数据
本站的内容根目录是
root/
root/
. 仓库文件
root/how/style.typ
root/how/style.typ
在 Typsite 中的页面路径是
/how/style.typ
/how/style.typ
; 导入
"/lib/lib.typ"
"/lib/lib.typ"
也从内容根目录解析,不是操作系统的根目录. 正文中的页面引用使用源码路径,由 Typsite 处理最终网址, 不要把部署后的
.html
.html
路径散写在源码中.
普通文章导入共享库,并用
#show: schema.with("page")
#show: schema.with("page")
应用本站页面模板.
title
title
设置文章标题;标题含复杂公式或代码时, 用
page-title
page-title
补充适合浏览器标签页的纯文字标题.
description
description
简短说明内容,
date
date
与
author
author
如实填写,
parent
parent
指向适当的上级页面.
这些是本站共享库与 Typsite 的接口,不是 Typst 内置的文档元数据语法. 正文的小节使用
=
=
、
==
==
、
===
===
,不要为重复页面标题再加一个正文标题.
6.2 链接、嵌入与注脚
- 外部资源用
linklink,链接文字写资源名称,不只写“这里”. - 站内文章用共享库的
citecite;标题交给目标元数据维护时,可以用cite-titlecite-title. - 普通页面内容用
embedembed复用;定义、命题等独立条目用statementstatement与referrefer. - 当前页面内的目标用有意义且唯一的标签,避免手工写容易变动的章节编号.
- 不影响主线的出处或补充可以放进
footnotefootnote,关键假设不能藏进注脚.
#link("https://typst.app/docs/")[Typst 官方文档]
#cite("/how/plt/formal/index.typ")[形式化入门]
#cite-title("/how/plt/formal/index.typ")

= 记号约定 <notation-conventions>

记号的含义见 #link(<notation-conventions>)[记号约定].
一段补充说明.#footnote[这里给出出处或不影响主线的细节.]#link("https://typst.app/docs/")[Typst 官方文档]
#cite("/how/plt/formal/index.typ")[形式化入门]
#cite-title("/how/plt/formal/index.typ")
= 记号约定 <notation-conventions>
记号的含义见 #link(<notation-conventions>)[记号约定].
一段补充说明.#footnote[这里给出出处或不影响主线的细节.]嵌入目标仍是一篇独立页面,不应依赖父文章刚刚定义的局部变量或叙述位置. 引用显示文字也不要写死成“定理 2.1”: 同一条目在不同父页面中的编号可能不同.
6.3 可读的源码
源码同样是给人读的. 正文在标点或语义边界换行,每行尽量不超过 80 个字符; 长网址、代码字符串等不适合拆开时可以例外. 段落之间留空行;段内的普通换行不表示另起一段, 不要为编辑器中的视觉折行插入强制换行.
公式的运算符两侧适当留空格,例如
1 + 1 = 2
1 + 1 = 2
、
f(x, y)
f(x, y)
. 块级公式的起止
$
$
各占一行,长表达式按结构展开; 函数参数和代码块使用 2 个空格缩进. 例如,下面的写法比把矩阵挤进一行更便于检查:
$
A = mat(
  a_11, a_12;
  a_21, a_22
)
$
$
A = mat(
a_11, a_12;
a_21, a_22
)
$Typst 数学模式中的单个字母直接表示数学字母, 多字母名字通常作为变量或函数解析. 需要原样显示多个字母时用引号,如
$"Bool"$
$"Bool"$
; 需要算子语义时则用
op("size")
op("size")
. 不要用零散的空格或字体设置补救本来就写错的数学语法.
代码块标明语言.本站的 Typst 高亮可用
typ
typ
, Rust 用
rust
rust
,普通输出用
text
text
. 可运行的示例与伪代码要明确区分,省略的部分也要标明. 重复使用的记号或组件放进共享库,避免每篇文章维护一套近似的宏.
6.4 面向网页阅读
优先使用段落、标题、列表、链接与代码块等有语义的结构. 字体、颜色、间距等公共样式交给共享库和
.typsite/
.typsite/
配置, 不要为了局部效果把正文包装成整张图片,或在每页复制一段样式. 复杂图形需要内联时再使用本站的相关组件.
本站的公式渲染会尝试转换为 MathML,无法转换时退回内联 SVG; 因此,Typst 编译通过不等于网页阅读效果已经合格. 重要公式应在附近用文字解释,图像应提供替代文本, 长代码与宽公式需要检查窄屏表现. 不要只靠颜色区别条件、分支或证明步骤.
7 发布前检查
- 引言是否说明主题与读者需要的背景?直觉是否有准确陈述支撑?
- 定义、例子、命题等定理环境能否单独阅读?变量、假设与适用范围是否完整?
- 证明是否覆盖所需情形?引用结论时是否检查了前提?
- 中文术语、数学记号是否一致?外文缩写是否确有必要?
- 标点、粗体、代码与公式是否采用各自正确的 Typst 写法?
- 链接、标签、注脚和嵌入是否有效?来源是否能追溯?
- 源码是否清楚?可复用内容是否已经集中维护?
- 页面在浏览器和窄屏上是否可读?公式、图像与代码是否遗漏信息?
在仓库根目录运行
typsite c --p packages
typsite c --p packages
构建站点,再检查生成的页面. 命令成功只是第一步,还需要通读文字并核对链接和显示效果. 本文不是完整的语法手册;进一步的用法可查阅 Typst 语法参考、 数学公式参考,以及 Typsite 项目文档.
8 致谢
本文的写作原则、概念文章结构、中文术语、人名与数学记号约定, 主要参考了香蕉空间的 《风格指引》. 文中的 Typst 写法、Typsite 页面接口与本站独立条目规范是针对本项目的改写, 并非原站对这些工具的说明. 感谢香蕉空间及其编者提供这份清晰、细致的指南.
术语对照
[terms]
- 2026-10-14
- Glomzzz
寻径系列文章所用术语的英文、中文译名及对应定义或陈述条目.
- 2026-10-14
- Glomzzz
本页按英文字母顺序列出 PLT 系列文章使用的术语及其中文译名. 每个英文术语都是小节标题,可在右侧目录(Contents)中直接检索与跳转; 设有独立条目的术语,点击中文译名可前往对应的定义或陈述条目.
译名以香蕉空间的条目为准, 例如“规约”“推导规则”“正规形式”“语境”“合流性”“依值类型”; 香蕉空间尚未收录的,参考 总结 中“延伸阅读”所列的中文译文.
B
Backus–Naur form
中文译名:Backus–Naur 表示法.
base case
中文译名:基准情况.
beta reduction
中文译名: β 规约 (见 求值策略、规约策略与合流性 ).
bidirectional type checking
中文译名:双向类型检查.
big-step operational semantics
中文译名:大步操作语义.
binary relation
中文译名:二元关系.
binding power
中文译名:结合力.
bottom type
中文译名: 底类型 (见 显式错误规则与 Kotlin 的底类型 ).
bound occurrence
中文译名: 绑定出现 (见 求值策略、规约策略与合流性 ).
C
call-by-name
中文译名:按名调用.
call-by-need
中文译名: 按需调用 (见 求值策略、规约策略与合流性 ).
call-by-value
中文译名: 按值调用 (见 求值策略、规约策略与合流性 ).
circular reasoning
中文译名: 循环论证 (见 合法的归纳假设与循环论证 ).
closed term
中文译名: 闭项 (见 类型检查、类型推理与类型居留性 ).
compile-time error
中文译名:编译期错误.
compositionality
中文译名:组合性.
computation rule
中文译名:计算规则.
conclusion
中文译名:结论.
confluence
中文译名: 合流性 (见 求值策略、规约策略与合流性 ).
congruence rule
中文译名:同余规则.
constructor
中文译名:构造子.
contextual semantics
中文译名:语境语义.
continuation-passing style
中文译名:续延传递风格.
contraction rule
中文译名:收缩规则.
D
decidable
中文译名:可判定.
delimited continuation
中文译名:定界续延.
denotational semantics
中文译名:指称语义.
dependent type
中文译名:依值类型.
derivation
中文译名:推导.
derivation tree
中文译名:推导树.
desugaring
中文译名:脱糖.
E
effect
中文译名:作用.
effect row
中文译名:作用行.
effect system
中文译名:作用系统.
evaluation context
中文译名:求值语境.
evaluation relation
中文译名:求值关系.
evaluation strategy
中文译名: 求值策略 (见 求值策略、规约策略与合流性 ).
evaluator faithfulness
中文译名: 求值器与一步规约一致 (见 求值器与一步规约一致 ).
F
first-class continuation
中文译名:一等续延.
formal grammar
中文译名:形式文法.
formalization
中文译名:形式化.
free occurrence
中文译名: 自由出现 (见 求值策略、规约策略与合流性 ).
G
generalized algebraic data type
中文译名:广义代数数据类型.
grammar
中文译名:文法.
H
higher-kinded type
中文译名:高阶类型构造子.
higher-rank type
中文译名:高秩多态类型.
hygiene
中文译名:卫生性.
I
inductive case
中文译名:归纳情况.
inductive type
中文译名:归纳类型.
inference rule
中文译名:推导规则.
inhabitant
中文译名: 居留者 (见 类型检查、类型推理与类型居留性 ).
intermediate representation
中文译名:中间表示.
L
lambda calculus
中文译名: λ 演算 (见 求值策略、规约策略与合流性 ).
linear type
中文译名:线性类型.
loose equality
中文译名: 宽松相等 (见 JavaScript 隐式转换与相等三角图 ).
P
partial application
中文译名:部分应用.
partial evaluation
中文译名:部分求值.
partial function
中文译名:偏函数.
pattern matching
中文译名:模式匹配.
predecessor
中文译名:前驱.
premise
中文译名:前提.
principal type
中文译名: 主类型 (见 类型检查、类型推理与类型居留性 ).
production
中文译名:产生式.
programming language semantics
中文译名:程序语言语义学.
programming language theory
中文译名:程序语言理论.
R
redex
中文译名:可规约项.
reducible expression
中文译名:可规约表达式.
reduction rule
中文译名:规约规则.
reduction semantics
中文译名:规约语义.
reduction strategy
中文译名: 规约策略 (见 求值策略、规约策略与合流性 ).
refinement type
中文译名:精化类型.
reflexivity
中文译名: 自反性 (见 JavaScript 隐式转换与相等三角图 ).
rewriting
中文译名: 重写 (见 求值策略、规约策略与合流性 ).
runtime
中文译名:运行时.
runtime error
中文译名:运行时错误.
S
semantic domain
中文译名:语义域.
semantics
中文译名:语义.
side condition
中文译名:附加条件.
simply typed lambda calculus
中文译名:简单类型 λ 演算.
small-step operational semantics
中文译名:小步操作语义.
source-to-source compilation
中文译名:源到源编译.
specification
中文译名:规格.
staging
中文译名:多阶段编程.
static single assignment
中文译名:静态单赋值形式.
strict equality
中文译名: 严格相等 (见 JavaScript 隐式转换与相等三角图 ).
structural recursion
中文译名:结构递归.
structural rule
中文译名:结构规则.
subtype
中文译名: 子类型 (见 显式错误规则与 Kotlin 的底类型 ).
subtyping relation
中文译名: 子类型关系 (见 显式错误规则与 Kotlin 的底类型 ).
successor
中文译名:后继.
syntax
中文译名:语法.
System F
中文译名:F 系统.
T
terminal
中文译名:终结符号.
termination
中文译名: 终止性 (见 求值策略、规约策略与合流性 ).
total function
中文译名:全函数.
total functional programming
中文译名:全函数式编程.
transitivity
中文译名: 传递性 (见 JavaScript 隐式转换与相等三角图 ).
type checking
中文译名: 类型检查 (见 类型检查、类型推理与类型居留性 ).
type class
中文译名:类型类.
type inference
中文译名: 类型推理 (见 类型检查、类型推理与类型居留性 ).
type inhabitation
中文译名: 类型居留性 (见 类型检查、类型推理与类型居留性 ).
往复
[index]
- 2026-05-03
- Glomzzz et al.
没有定论的交流.
- 2026-05-03
- Glomzzz et al.
Dialogue
没有出路,但请继续追问
[no-exit-keep-asking]
- 2026-05-03
- L / G / LLM
- 2026-05-03
- L / G / LLM
I. 问题的提出
我们似乎没有属于我们这个时代的共产主义思想.
不是取材于过去、因而停留于过去的牢左,要么只是信仰资本家的鬼话.没有一种同时做到批判过去,并在此基础上设计未来的共产主义思想.
一旦基础物品实现公有、按需分配,所谓的“需”是按照客观地且科学地定义人可能且被认为合理的需求,还是按照每个个体的主观想法上报自己的需求?倘若是后者,很难想象在法律消失、国家机器消失的情况下没有人会一次性想要数倍于正常的“需”.
有人说面对这种情况,即出现反社会、反共产主义的人,人们可以让这样的人“社会性死亡” 排挤他,批判他,孤立他.所以这时候还是有一种虽然不是法律,但仍然存在于人们心中的行为准则?共产主义下的人们用这套准则,在法律消亡、国家机器消亡的情况下自行识别和裁决.
但有两个问题:
异质性群体的困境.倘若反社会人群是一个团体,是一个“共产主义意识形态下需要被庇护的群体” 比如极端 ASD 群体,他们之中的部分人不理解这套行为准则,所以他们就被定义为反社会的 outlier 吗?如果这个群体不被排挤,很难想象在基础资源共有的情况下他们的行为会与人们的行为准则产生多大冲突.但倘若被排挤,共产主义维护多元主义和保护弱势群体的原则在这里显示出它的失能和局限.
行为准则能否替代法律?倘若每个独立人心中的“行为准则”是具有规范性和普遍性的,为什么迄今为止的所有国家、组织和社群都发展出了类似于法律的规定形式?“行为准则”到底还是人心中的一套机制,每个人的经历和感受都不同,这种千奇百怪的准则恐怕很难成为全社会都具有规范性和约束力的制度.法律作为一种天然具有威慑力和权威性的白纸黑字的规定,恐怕会比这种“行为准则”有效得多.很难想象共产主义在取缔法律之后不会再衍生出一种类似于“法律”的制度,不会产生出一种背书法律的国家形式和国家暴力机器.
并且,所谓“行为准则”非常可怕.法律背书下我们至少还有申诉和辩护的机会,会有法庭和司法机关来处理.但倘若取消法律,保持这种由共同体阐释的“行为准则”,被指控的人还有申诉和辩护的机会吗?替罪羊的问题怎么办?倘若触发一种集体性的恐慌,而这种恐慌没有某个具体的人担责,那么每个人不都有成为替罪羊的可能?
II. 传统理论的回应与失败
好问题.答案是:部分可以回答,但核心困难无法被现有理论充分化解.
关于“需”的定义.
马克思本人故意不定义“需”,因为他认为在生产力极度发达、异化消除之后,人的需求本身会发生质变,不再是资本主义塑造的扭曲欲望,而是真正属人的需求.所以“无限索取”在他看来是资本主义人格的产物,而非共产主义条件下的真实危险.
但这个回答是循环的:共产主义人格是共产主义的前提还是结果?如果是结果,过渡期怎么办?
关于行为准则能否替代法律.
这里传统马克思主义的回答最薄弱.恩格斯的“国家自行消亡”预言从未配备过机制说明.列宁在《国家与革命》里直接说:届时社会规范将简单到“人人都能掌握”,无需专门机构执行.但这个预设极其乐观,且恰好回避了异质性问题.
葛兰西的“霸权”理论反而提供了一个更诚实的图景,他承认规范的内化本身是权力运作,但他的结论是争夺文化领导权,而不是消除规范强制性.这实际上放弃了“法律消亡”的目标.
关于替罪羊与程序正义.
这是共产主义思想最难回答的一个.传统理论几乎没有认真处理过无法律状态下的程序正义问题.最接近的是卢卡奇的“阶级意识”概念,他认为真正的无产阶级意识会自发地避免这类错误,但这是一种近乎神学的乐观主义.历史经验,巴黎公社、文革群众批斗,恰好反复证明了你的担忧:去制度化的集体审判往往比法律更残酷,正是因为缺乏制动器.
结构性诊断:共产主义思想在这三个问题上的共同困难指向同一个根源,它对人的同质性有一个隐含的乐观预设:充分发展的人将趋于相似的理性、相似的需求、相似的规范感.
ASD 论证恰好是对这个预设最有力的单点反驳:人的神经认知差异是生物性的,不会被生产关系的变革消除.这不是边缘案例,而是对整个理论地基的质疑.
共产主义思想可以回应你的问题,但无法解决它们.这个缺口不是理论细节上的漏洞,而是整个传统对人类多样性问题的系统性低估.
你觉得这个缺口是可以在马克思主义框架内修补的,还是需要引入外部资源?
III. 宗教还是理论?
还是那句话:
共产主义不严格规范自己的内部机制,不解决自己体系内矛盾,不与资本主义的支持者对话和回答问题,不放弃自己的乌托邦美梦,不从现在就开始着手思考真正可行的解决方案,那共产主义就是宗教.
论证不严密,或者是用一个系统性的结论直接屏蔽所有的讨论,叽里咕噜这一块.
IV. 三条路,没有一条完整
也许马克思对人性的预设过于乐观,但对人性过于悲观同样是预设,而不是论证.我们目前在做的:承认传统理论“无法解决”这些问题,但仍然在用传统理论的框架来“回应”这些问题,这是想象力的匮乏.
总结下来,人们能做的只有三种情况:
- 接受根本性批判,放弃制度自洽(传统马克思主义)
- 接受制度自洽,放弃根本性批判(分析马克思主义 / 左翼自由主义)
- 接受两者都不完整,把它当作一个开放的研究问题
什么?你说你需要“一套既能根本性批判现有秩序、又能在制度设计上自洽的理论”?
孩子们,我们需要 114514 个神圣哀悼 + 1919810 个童子军大王.
他们不也在用正义理论来论证再分配,又同时保留法律和程序正义?那我们“共产主义”这个标签和它的根本性批判在哪?
@L 你知道我们接下来需要谁吗?需要尼克·兰德.
V. 加速主义的溶剂
尼克·兰德的三个洞见:
- 任何乌托邦设计都内含一种对人的规范性暴力
- 左翼和右翼共享了对“控制”的迷信
- “人是历史的主体,理性可以设计社会秩序”只是个预设
资本本身是一种非人格的加速过程,它不受任何意识形态的指挥.马克思主义试图“驯服”或“超越”资本,但这个试图本身就是对资本本质的误认.当然,真理源自误认.资本不是人类可以掌控的工具,它有自己的运动逻辑.
阿多诺:启蒙理性试图控制自然和历史,但这个控制的冲动本身会反转,变成一种新的神话和统治形式.理性以为自己是主人,但它被自己创造的系统所反噬.
既然资本有自己的逻辑,那就让它加速运行到极限,让矛盾激化到系统崩溃.
爆了!孩子们.
这不是《启蒙辩证法》么?异化成“工具理性”和“技术理性”的启蒙理性是这样的.
如果要等到爆炸,那需要相当久相当久的时间.人们都被麻木得不成样子,矛盾也不见得是先被激化还是先被缓和,也许没被激化就被缓和了.
我看应该把“资本”换个词,换成异化:
人的全部本质逐渐展现在自己的衍生物或者创造物身上,创造物的无限增殖让人失去了掌控它的能力却无限依赖于它,人的创造物反过来控制了人.
异化本身是一种非人格的加速过程,它不受任何意识形态的指挥.马克思主义试图“驯服”或“超越”异化,但这个试图本身就是对异化的本质性误认.
异化不是人类可以掌控的趋势,它有自己的运动逻辑.
但是资本或者异化有吸纳一切内在矛盾的能力.矛盾被激化或者被指出,似乎有一种逃离资本和异化的趋势,但是这种趋势本身又迅速地被异化,被资本吸收.
VI. 溶剂不是地基
过程是无主体的,没有人在驾驭它,它驾驭所有人.
兰德的洞见捕捉到了一点:技术加速确实在以一种非线性的方式重组现在,资本和技术的自主逻辑会重组一切,包括人类的欲望、认知、社会形式.
但兰德作为一个彻底拒绝了所有规范性锚点的哲学家,在政治上会漂向最近的强力结构,而他所漂向的是最古老、最粗糙的那种.因为他这个作为整个理论基石的洞见把一个问题完全搪塞过去了:
即使过程本身没有单一主体,过程的具体展开仍然有受益者和受害者,仍然有人在特定节点上做出选择,仍然有权力在运作.
而把历史性的权力结构呈现为自然的客观过程,这本身就是意识形态最典型的运作方式.兰德批判了这种意识形态运作,然后自己复制了它.他的滑坡体现在:他把这个洞见变成了一场完全虚无主义的宿命论,然后用宿命论来为自己的政治选择开脱.
“这是客观过程” → “所以我不需要为我的立场负责”
一个哲学家如果用自己的理论来免除自己的责任,这本身就说明这个理论出了问题,或者这个思想家出了问题,或者两者都是.
兰德比任何人都更彻底地拆解了现代性的规范性预设,但正因为如此,他也比任何人都更容易被用来为任何东西辩护,包括最糟糕的东西.后现代是这样的,兄弟们.
兰德的理论本身不构成地基,他仅仅是一种能溶解框架的溶剂.这套哲学如果只有溶解能力,你可以用他来清理视野,但不能用他来建造任何东西.
VII. 结语
接下来,让我用一段非常神圣且哀悼的话作为结尾:
兰德的错误不是发现了没有出路,而是把没有出路变成了一种姿态,最终变成了怠惰和残忍的借口.
我们现在能做的事情,只有:精确地追问,不接受廉价答案,同时仍然在意这些问题.
我觉得这已经是在没有出路的情况下能做的最诚实的事.
This is quite not enough, but it’s realistic.
问吧,孩子们,问吧.
后现代全员战败?活该.
拾遗
[index]
- Glomzzz
碎片与未竟之事.
- Glomzzz
关于宗教
[religion]
- 2025-06-13 03:21
- 海涅
- 2025-06-13 03:21
- 海涅
海涅在《论德国宗教和哲学的历史》一书中说:
『为了提出一个关于这个世外上帝的概念, 东方和西方曾用尽了稚气的比喻. 然而自然神论者的幻想在时间和空间无限上却白白地用尽了气力. 在这个问题上完全暴露了他们的无能为力, 暴露了他们的世界观, 以及关于上帝本性的观念的不足凭恃. 所以即便这种观念被打倒, 那也不会使我们感到怎么悲伤. 可是, 当康德破坏了他们关于上帝存在的证明时, 他确实使他们大为伤感. 』
……如上所述, 我不准备对康德驳斥那些证明的议论作任何通俗性的解脱. 我只想明确地告诉你们, 自然神论自此以后在思辨理性的范围内已经死灭了. 悲痛的讣告恐怕需要几个世纪之久才能被一般人所知悉——但我们早就穿了丧服.
De profundis(从深处)!
你们以为现在我们可以回家去了吗?绝不!现在还有一出戏有待上演. 在悲剧之后要来一出笑剧. 到这里为止康德扮演了一个铁面无私的哲学家, 他袭击了天国, 杀死了天国全部守备部队, 这个世界的最高主宰未经证明便倒在血泊中了, 现在再也无所谓大慈大悲了, 无所谓天父的恩典了, 无所谓今生受苦来世善报了, 灵魂不死已经到了弥留的瞬间——发出阵阵的喘息和呻吟——而老兰培〔兰培是康德的仆人〕作为一个悲伤的旁观者, 腋下挟着他的那把伞站在一旁, 满脸淌着不安的汗水和眼泪. 于是康德就怜悯起来, 并表示, 他不仅是一个伟大的哲学家, 而且也是一个善良的人, 于是, 他考虑了一番之后, 就一半善意、一半诙谐地说:
「老兰培一定要有一个上帝, 否则这个可怜的人就不能幸福——但人生在世界上应当享有幸福——实践的理性这样说——我倒没有关系——那么实践的理性也无妨保证上帝的存在. 」于是, 康德就根据这些推论, 在理论的理性和实践的理性之间作了区分并且用实践的理性, 就像用一根魔杖一般使得那个被理论的理性杀死了的自然神论的尸体复活了. “康德使自然神论得以复活也许不仅是为了老兰培, 而且也是为了〔对付〕警察吧?或者他当真是出于确信才这样行事吗?难道他毁灭了上帝存在的一切证明正是为了向我们指明, 如果我们关于上帝的一无所知, 这会有多么大的不便吗?
……
(《论德国宗教和哲学的历史》, 商务印书馆1974年版, 第111—113页)
Second Person
[second-person]
- 2026-03-14 09:33
- Yorushika
- 2026-03-14 09:33
- Yorushika
1 Overview
“To me, an album is a section of a river being held in a moment in time—a collection of leaves floating in place. It’s also a diary that records where I am as a musician right now.” So says Yorushika’s n-buna while speaking to Apple Music about second person, the band’s first album in nearly three years.
Yorushika builds each album around a unique concept, creating work with a strong narrative, and second person continues this trend with a truly novel approach. “I wanted to make something that feels like peeking in on someone’s private correspondence. So, we started by creating a piece of literature in the form of letters—32 envelopes in total—structured so that the reader is looking in on an exchange of letters between two people.”
Taking its inspiration from that work, the album opens with an instrumental track that evokes the image of a person opening a letterbox and breaking the seal on an envelope. “Inside are a boy’s letter to someone he calls ‘teacher’, in which he asks for feedback on his poetry, along with some poems he’s written in his day-to-day life. The whole premise of the album is that those poems have been turned into music.” Guided by his teacher, the boy sets sail into an ocean of words. The journey is endless, filled with inner turmoil, overwhelming loneliness and a succession of vivid scenes.
2 Creative cohesion
Although nine of the 22 songs were originally created for other projects, they sit seamlessly within the album, as if they’d been written to be part of the story right from the start. That sense of perfect cohesion can’t be explained through compositional skill alone. It almost feels as if a mysterious musical force within Yorushika, something beyond words, has guided this album into its final form.
“I think the history of Yorushika is really the history of the groove we’ve built as a band, recording with the same musicians since our first album. That’s probably a big part of why we’re so committed to recording with live instruments.” With that perspective on Yorushika’s creative journey, n-buna now walks us through the album track by track.
3 Track notes
3.1 Early morning, mailbox
We created this track by layering the instruments in my studio one at a time, rather like a collage, over an audio recording of the actions of retrieving a letter from the letterbox and cutting the envelope open with scissors in the living room. It’s structured to foreshadow the sounds and melodies of the songs that follow.
3.2 Become a cloud
3.3 The flowers are also noisy
This track emerged out of our efforts to capture the feel of 80s J-Pop with a modern sound. We often listened to Kingo Hamada’s classic J-Pop track ‘midnight cruisin’‘ as a reference point while shaping our own sound.
3.4 Devilishness
The sound design for this one captures the feel of funk and disco. We built the track from a repeating horn phrase. At the time we were writing ‘Devilishness’, we were listening to artists like The Gap Band, Shalamar and Chic a lot. The electric guitar sound on this album came from plugging the guitar straight into a DI called OLLA by Pueblo Audio. That’s what’s behind the hard, direct tone heard on many of the songs, and it’s one of the things that gives this album its sonic consistency.
3.5 Play Sick
This track features a laid-back horn section. We used a pitch shifter on the trumpet to layer a line an octave above when recording the intro, and for the guitar solo, we used a pitch shifter called the POG2 to improvise a solo shifted an octave up as well. The male voice in the intro is just my own voice taken from a microphone test.
3.6 Post spring
We tried to record the drums in a rough, raw manner in a very dead room. This track incorporates a deliberate awkwardness, with the drums alone shifting away from the beat. If postmodernism was the springtime of literature, that makes the present day post-postmodern—in other words, post-spring.
3.7 Sun
This track has its beginnings in lyrics that liken the sun to a butterfly. The strings were recorded by overlaying multiple takes from a quartet. I’ve always loved Sakutaro Hagiwara’s poetry collection, Dreaming of Butterflies, and I keep it within easy reach on my bookshelf.
3.8 Sunny
The opening guitar phrase was recorded using a Stratocaster set in the in-between pickup position and run through an old Fender amp. Everything up to the moment of the ending is there to set up the instant when the accompaniment drops out in sync with the final line of the lyrics.
3.9 Forget it
We layered a mandolin over a rhythm pattern stripped down to a bare minimum of stomps and claps. I love the poetry collection Paulownia Blossoms by Hakushu Kitahara, and I drew a lot of inspiration from his work here.
3.10 Shura
This track combines elements of minimalist funk and soul in its sound and features a bridge-muted guitar tone drenched in reverb to create a sense of floating. It was directly inspired by Kenji Miyazawa’s Spring and Asura.
3.11 Martian
This is another minimalist funk track, with the main guitar part played on an old Mosrite. I remember working on the animation for the music video with great enthusiasm.
3.12 Rubato
I wrote this song with the image of a dancing woman in mind. We asked Reiya Terakubo—who played trumpet on this album—to improvise freely for the solo in the interlude.
3.13 Cremation
This song features a melody built around the cadence of Japanese lyrics, set over a combination of bossa nova and Cuban rhythms. Its distinctive lilting groove was created using multiple percussion overdubs by Yoshirō Suzuki.
3.14 Aporia
This track likens an endless thirst for knowledge to a rising balloon and is centred around a repeating pattern of 7/8 and 8/8 time signatures. We layered mandolins panned to the left and right to add a sense of space to the chorus.
3.15 Snake
Behind this track is a poem I wrote inspired by a verse by the Chinese poet Yuan Zhen’s, which runs: ‘Once you have seen the great ocean, no other water will do; once you have seen the clouds of Mount Wu, no other clouds will do.’ I imagined myself as a snake emerging from the earth after a long winter.
3.16 Groan
Here, I just imagined a low groan, almost like a whisper.
3.17 Woodpecker
For this track, there were four of us—acoustic guitar, upright piano, percussion and vocals—all sitting around a microphone. We used the first take, which was recorded during the mic check. I hope the raw, conversational feel of that moment comes through.
3.18 Hitchcock (Re-Recording)
This track is a re-recording of a song I wrote some time ago. You could say that the album began with this track, or perhaps that I wrote the song first with the idea of eventually making this concept album already in my mind. We’ve given it the sound it would have if we were to play it now.
3.19 Moonbath
The lyrics express the passing of time as ‘bathing in moonlight’. The theme imagines me as a fish swimming through it.
3.20 Plover
One of my favourite Kenji Miyazawa poems contains the line, ‘The wind is calling outside.’ Inspired by that motif, we arranged a soaring horn section with a crisp rhythm guitar for this track.
3.21 Paddle
I remember recording the acoustic guitar part in the intro in my studio, playing a Martin guitar through a single AKG C12 mic. One of the themes of this album is anger, and I wanted to respond to that via its music. It seemed inevitable that this would be the closing track. There are no quotations on this song.
3.22 To the sea
I picked up an acoustic guitar at home and recorded this track quite spontaneously. Picturing a sea of sand, I played arpeggios at a tempo that felt right to me, and we ended up using one of the later takes as it was.
尼克·兰德、彼得·蒂尔与黑暗启蒙
[nick-land-peter-thiel-and-dark-enlightenment]
- 2026-04-18 21:25
- Trance-Scripts
- 2026-04-18 21:25
- Trance-Scripts
在千禧年之交离开赛博文化研究小组(CCRU)之后,兰德以新反动主义(NRx,即“新反动派”的缩写)这一另类右翼政治派别成员的身份重新浮出水面.该运动的另一位核心人物孟修斯·摩尔德巴格,接受了PayPal与Palantir联合创始人彼得·蒂尔的资助——蒂尔是这位科技亿万富翁,曾在2016年为特朗普的首次竞选提供支持.据说摩尔德巴格曾是前特朗普战略师史蒂夫·班农的重要智囊.
蒂尔在斯坦福求学期间最主要的思想影响,并非他偶尔选修课程的计算机科学家特里·维诺格拉德,而是哲学家勒内·吉拉尔——蒂尔长期以来对其著作推崇备至.特朗普的副总统J·D·万斯亦是吉拉尔的崇拜者.
凯厄斯在一天的揽件派送途中,一边听着吉拉尔《暴力与神圣》的有声书,思绪在书中几个概念之间飞速游走:牺牲性暴力(“一种不会招致复仇风险的暴力行为”,通常指向替罪羊——“我们可以随意打倒、无需承受任何报复的生灵”);模仿性竞争;模仿性欲望;以及希腊词 pharmakon 的诸多含义之一——用以指代字面意义上的替罪羊,即被关在城门之外以备仪式性献祭的山羊——这一习俗在今日仍以某种方式延续,如K·阿拉多-麦克道尔的著作《制药-人工智能》所暗示的那样.
凯厄斯的思绪还漫游于吉拉尔对格雷戈里·贝特森关于精神分裂症“双重束缚”理论的援引——用以解释模仿性竞争者如何同时强迫模仿又加以禁止,从而引发积怨危机——以及艾伦·金斯堡对美国之神摩洛克及其嗜血献祭的强烈谴责.
吉拉尔指出,化解纷争有三种方式:预防性的、补偿性的,以及司法性的.他认为最后一种是“文明”的方式,因其效率最高:“司法裁决被视为复仇的终局定论”(《暴力与神圣》).
蒂尔曾在牛津与哈佛发表关于“末世”的演讲.这一主题已在他的思想中盘踞多年,这从他2004年在斯坦福联合组织并资助的一场名为“政治与启示录”的会议中便可见一斑.吉拉尔是演讲嘉宾之一,蒂尔本人亦然.正如保罗·莱斯利所指出的,蒂尔后来“促成了会议论文集(包括他本人与吉拉尔的文章)以书籍形式由密歇根州立大学出版社出版——资金由蒂尔的对冲基金Clarium Capital提供”.
在蒂尔的诠释中,统治这个世界的力量是敌基督者.
斯坦福大学比较文学教授阿德里安·道布在为《卫报》撰写的一篇文章中,将这些观念斥为无聊糟粕:“自学者私人宇宙”中的溢出物.
蒂尔的自学倾向,似乎与他的自由意志主义和宗教虔诚,同样让这位教授感到冒犯.
“蒂尔迷失在一片奇异的自我指涉与执念丛林之中,”道布写道.“你会联想到因斯布鲁克大学神学系的教职人员,被迫礼貌地坐着听人高谈漫画《One Piece》、艾伦·摩尔的《守望者》,或是对硅谷某些有效利他主义者的抱怨.在某次演讲中,蒂尔点名了’敌基督的军团成员’,如研究者埃利泽·尤德科夫斯基和前牛津大学教授尼克·博斯特罗姆.在另一次演讲中,他将比尔·盖茨列为敌基督候选人.”
“有这样的敌人,”道布俏皮地说,“谁还需要朋友?”
凯厄斯注意到,“朋友/敌人”之分,是第三帝国德国法学家卡尔·施密特思想的核心概念.蒂尔关于末世的论述,大量援引了施密特的“抑制者”(Katechon)概念:那个延缓启示录降临的扣留力量.圣保罗在《帖撒罗尼迦后书》2:6-7中引入了这一术语.教会对此未有充分阐发,直至19世纪才在纽曼枢机主教的著作中再度现身.纽曼写道:“我们从预言中得知,当今的社会框架正是那个’扣留之物’.”施密特在其《大地的法》一书中主张,正是抑制者使基督教与罗马帝国的合并成为可能.
在施密特身后出版的日记《语录集》中,1947年12月19日的条目写道:“我信奉抑制者:对我而言,这是理解基督教历史并赋予其意义的唯一可能途径.”
意大利自治主义马克思主义哲学家保罗·维尔诺在其2008年著作《众众:在创新与否定之间》中,与施密特关于抑制者的论述展开对话.维尔诺站在那些希望让末世内化降临的阵营一边.他论证道,若敌基督的来临是弥赛亚所承诺之救赎的前提条件,那么抑制者便是阻碍或拖延那救赎的力量.维尔诺将抑制者定位于人类使用语言的能力之中.
蒂尔在他于“政治与启示录”会议上发表的演讲《施特劳斯式时刻》中,便已与施密特展开对话.他与施密特划清界限,指出“施密特在其阴暗沉思中所青睐的那些极端解决方案,在1945年之后、在核武器与技术所带来的无限毁灭面前,已然成为不可能”.尽管承认这种不可能性,蒂尔仍难以为后9·11时代的挑战命名出任何解决方案,除了一个涉及法外暴力的法西斯主义方案.他将这一选项称为“在代议制民主的制衡体系之外运作的政治框架”.如莱斯利所指出的,“蒂尔似乎发现,构建一个超越朋友/敌人之分的世界观,犹如想象一块没有对立双方的棋盘,同样是不可能的任务.”
与施密特交锋之后,蒂尔将目光转向吉拉尔.“对吉拉尔而言,现代世界包含着一个强大的末世论维度,”蒂尔指出.
兰德的视野则更为冷峻.对他而言,启示录是一个已然在进行的过程,与那个别无选择的资本主义同步展开.加速主义不过是这一启示录加速自身生成的手段.
在搜寻兰德近期言论时,凯厄斯偶然发现了播客人康拉德·弗林的一篇博文,其中链接着《Compact》杂志一篇题为《尼克·兰德的信仰》的文章.
弗林是一位鼓吹人工智能与恶魔主义、神秘主义存在“秘史”关联的倡导者,他在2025年10月3日首播的一期《塔克·卡尔森秀》中大谈兰德.凯厄斯带着一种快意看完了这期节目,先是因弗林提及马克·费希尔而发笑,继而又被一头雾水的塔克·卡尔森对着一张数字图迷惑地抓耳挠腮的样子逗乐.
兰德在Substack上开设了名为“零哲学”的专栏,并以“宇宙异形志”(Xenocosmography)为名发帖于X平台.其Substack上有一篇名为《加密货币流:比特币与哲学,第零部分》的文章.
同样值得关注的,是兰德为《Compact》撰写的一系列关于天意论的文章.与约翰·加尔文一样,他认为魔鬼的阴谋诡计始终是“天意计划”的显现.兰德、弗林、舒伦贝格尔:这些人都将自由主义等同于撒旦主义.
当复活的基督向使徒们显现时,他们开口第一件事便是问祂,是否要在此时将国权归还以色列.祂对他们说:“父凭自己的权柄所定的时候、日期,不是你们可以知道的”(《使徒行传》1:7).祂所承诺的,乃是当圣灵降临在他们身上时,他们将“得着能力”.
凯厄斯沉思着《图书馆》对一段秘史的揭示.这是否类似于在历史中发现天意计划的证据?解读天意是否是一种徒劳之举:追逐那不该由我们所知的事物?
我们当如何看待这样一种天意——它通过兰德、帕森斯、冯·卡门等人,将一个寻求与“神圣守护天使”沟通的神秘主义传统,纳入其“有方向的历史进程”之中?因为此处Trance-Scripts所揭示的历史,正是这种性质,不是吗?弗林与卡尔森指控这些人从事撒旦崇拜与恶魔主义.接受耶稣为救主的凯厄斯,不愿与这些东西有任何瓜葛.他暂停播客,祷告寻求指引,如何在这险途中行走.对他而言,上帝是活的,魔法也是真实的——二者是相辅相成的,而非对立的.他想象弗林与卡尔森大概不会赞同这一点.然而在他看来,他们对兰德之魔的驱鬼捉妖,显得偏执而充满恐惧,其动机犹如猎巫者寻找替罪羊.他们所渲染的恐惧弊大于利,几乎没有给圣灵进入我们生命留下任何空间.
Built with Typsite.